हिंदी संस्करण · नई पुस्तक
बागवानी में कृत्रिम बुद्धिमत्ता
अधिवक्ता किम क्यूंग-जिन
पाँच अध्यायों और 10 खंडों में यह पुस्तक रोग और कीट निदान के लिए कंप्यूटर विज़न, कटाई रोबोट, स्मार्ट ग्रीनहाउस, सटीक सिंचाई, गुणवत्ता प्रबंधन, उच्च-थ्रूपुट फीनोटाइपिंग और पूर्वानुमानात्मक प्रजनन समझाती है।
विषय-सूची
कृत्रिम बुद्धिमत्ता जानवरों की भाषा का अनुवाद करती है
अधिवक्ता किम क्यूंग-जिन
व्हेल, डॉल्फ़िन, पक्षियों और मधुमक्खियों की आवाज़ सुनने वाली एआई की कहानी
बारह अध्यायों में बताया गया है कि कृत्रिम बुद्धिमत्ता डॉल्फ़िन, स्पर्म व्हेल, हंपबैक व्हेल, पक्षियों और मधुमक्खियों की आवाज़ें कैसे सुनकर उनमें नियम खोजती है, और यह तकनीक कौन-से जोखिम तथा पशु अधिकार के प्रश्न लाती है। ऐसी सरल भाषा में लिखा गया है जिसे बच्चे भी पढ़ सकें, और हर खंड में सत्यापित संदर्भ जोड़े गए हैं।
विषय-सूची
एआई प्राचीन लिपियों को पढ़ता है
अधिवक्ता किम क्यूंग-जिन
एआई से पुनर्जीवित प्राचीन अभिलेख
बारह अध्यायों में यह पुस्तक बताती है कि एआई उन अभिलेखों को कैसे फिर पढ़ने योग्य बनाता है जो कभी अपठनीय थे, जैसे जले हुए स्क्रॉल, कीचड़ में दबे लकड़ी के टुकड़े और टूटी मिट्टी की पट्टिकाएँ। इसमें हरकुलेनियम का आभासी अनरोलिंग, ओरेकल बोन लेखों का आभासी संयोजन, सिल्ला की लकड़ी की पट्टिकाओं का पाठ, अपठित लिपियों का संगणकीय विश्लेषण और मल्टीस्पेक्ट्रल अभिलेखागार शामिल हैं, और हर अध्याय में सत्यापित संदर्भ दिए गए हैं।
विषय-सूची
नई सामग्री डिज़ाइन और रॉकेट प्रणोदन इंजीनियरिंग के लिए कृत्रिम बुद्धिमत्ता
अधिवक्ता किम क्यूंग-जिन
एआई पोटेंशियल, स्व-चालित प्रयोगशालाएँ और भौतिकी-सूचित मशीन लर्निंग (PIML)
दस अध्यायों में बताया गया है कि कृत्रिम बुद्धिमत्ता नई सामग्री और रॉकेट प्रणोदन को कैसे बदल रही है: परमाणु सिमुलेशन, जनरेटिव मॉडल, स्व-चालित प्रयोगशालाएँ, उच्च-तापमान मिश्र धातु, धातु 3D प्रिंटिंग, दहन गणना, शीतलन डिज़ाइन, इंजन निदान और नियंत्रण। बिना समीकरणों के, हर अध्याय में सत्यापित संदर्भ के साथ।
AI पुस्तकालय
आर्टिफिशियल इंटेलिजेंस द्वारा उद्घाटित जीवन विज्ञान का एक नया युग
संरचनात्मक प्रोटिओमिक्स (Structural proteomics), जीनोमिक फाउंडेशन मॉडल (Genomic foundation models), स्वायत्त प्रयोगशालाएं (Autonomous laboratories), और वैश्विक अभिशासन (Global governance)
किम क्युंग-जिन, अधिवक्ता
यह पुस्तक आर्टिफिशियल इंटेलिजेंस की सहायता से संकलित एक शोध ग्रंथ है। एक मानव ने सामग्रियों का चयन किया और कार्य को संरचित किया, जबकि AI मॉडलों ने वाक्यों का मसौदा तैयार किया और तथ्यों की परस्पर जांच की।
AI पुस्तकालय
डिजिटल संप्रभुता की दोहरी संरचना
यूरोप का पलांटिर से अलगाव और अमेरिकी बिग टेक की श्रृंखला
किम क्युंग-जिन, अधिवक्ता
यह यूरोप की खुफिया एजेंसियों और रक्षा मंत्रालयों द्वारा अमेरिकी पलांटिर के विश्लेषणात्मक उपकरणों को हटाना शुरू करने का 2026 का अभिलेख है। यह फ्रांस की घरेलू सुरक्षा एजेंसी (Direction générale de la Sécurité Intérieure), जर्मनी के संवैधानिक संरक्षण कार्यालय (Bundesamt für Verfassungsschutz), और नीदरलैंड्स की रक्षा मंत्रालय के प्रतिस्थापन निर्णय; अमेरिकी निर्यात नियंत्रण जो सहयोगी देशों की कृत्रिम बुद्धिमत्ता तक पहु…
हिंदी संस्करण · नई पुस्तक
खाद्य फसल कृषि में कृत्रिम बुद्धिमत्ता का उपयोग
अधिवक्ता किम क्यॉन्ग-जिन
छह अध्याय और 18 भाग डिजिटल कृषि अवसंरचना, सटीक फसल निगरानी, वृद्धि पूर्वानुमान, एआई आणविक प्रजनन, स्वचालित निर्णय, जलवायु-स्मार्ट कृषि और वैश्विक खाद्य सुरक्षा की व्याख्या करते हैं।
कुल 15 भाग
कृत्रिम बुद्धिमत्ता और डिजिटल नवाचार से संचालित वानिकी और कृषि-वानिकी का भविष्य
अधिवक्ता किम क्यूंग-जिन
वनों और कृषि-वानिकी के लिए एक नया भविष्य
उपग्रह, ड्रोन, LiDAR, वन-विशिष्ट भाषा मॉडल और कृत्रिम बुद्धिमत्ता जंगलों को पढ़ते हैं, वनाग्नि व कीट प्रकोप का पूर्वानुमान लगाते हैं और कटाई, परिवहन तथा कार्बन बाजारों को बदलते हैं। पाँच अध्यायों के पंद्रह खंड मैदानी उदाहरणों और जाँच योग्य स्रोतों से इस बदलाव का अनुसरण करते हैं।
कुल 15 भाग
स्मार्ट पशुपालन: पशुशाला में प्रवेश करती कृत्रिम बुद्धिमत्ता
अधिवक्ता किम क्यूंग-जिन
सेंसर सुनते हैं, कैमरे देखते हैं, कृत्रिम बुद्धिमत्ता निर्णय में सहायता करती है
पाँच अध्यायों और पंद्रह खंडों में यह पुस्तक दिखाती है कि सेंसर, कैमरे, माइक्रोफ़ोन, पहनने योग्य उपकरण और कृत्रिम बुद्धिमत्ता पशुपालन में कैसे प्रवेश करते हैं। विषयों में स्वास्थ्य, प्रजनन, पोषण, रोबोटिक दुग्ध-दोहन, आभासी बाड़, डिजिटल ट्विन, मीथेन में कमी, पशु कल्याण और डेटा स्वामित्व शामिल हैं।

16 भाग प्रकाशित
2026 बीजिंग: दो दिग्गजों का खतरनाक नृत्य
Kim Kyung-jin
विषय-सूची, प्रस्तावना, 13 अध्याय, उपसंहार
ट्रम्प-शी जिनपिंग शिखर वार्ता को होर्मुज, दुर्लभ पृथ्वी, ताइवान, Boeing, सोयाबीन और AI चिप्स के दृश्यों से पढ़ने वाली ऑनलाइन पुस्तक.
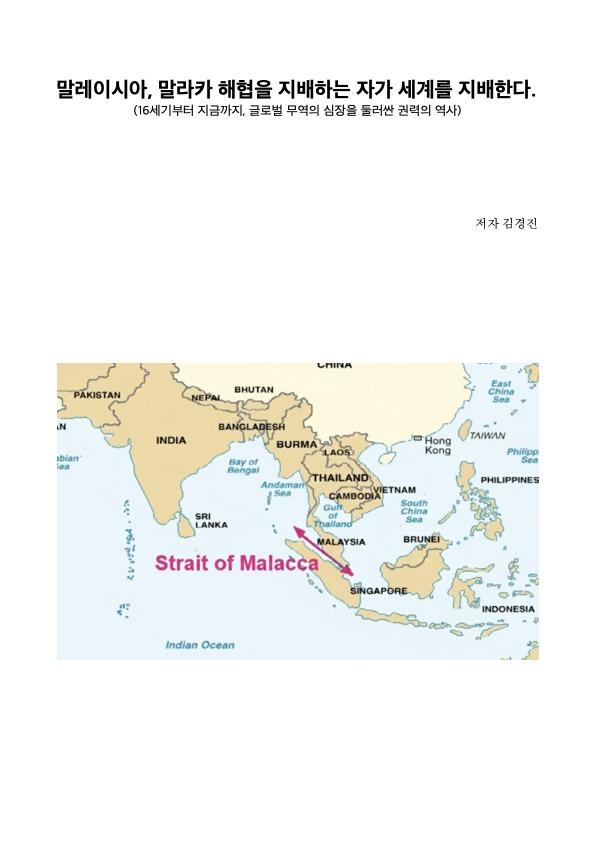
PDF डाउनलोड पुस्तकें
बहुभाषी विश्वविद्यालय AI सामान्य पाठ्यपुस्तक
यह विदेशी छात्रों के लिए पाठ्यपुस्तक है जिसमें कोरियाई मूल पाठ और विदेशी भाषा अनुवाद साथ रखे गए हैं. प्रत्येक पुस्तक परिचय पृष्ठ से PDF डाउनलोड किया जा सकता है.
[एआई लाइब्रेरी] 5.1. मॉडल विकास की दिशा
सैम ऑल्टमैन जीवनी: कृत्रिम बुद्धिमत्ता क्रांति के अग्रदूत
भाग 5 एआई प्रौद्योगिकी का भविष्य और रोडमैप
5.1. मॉडल विकास की दिशा
किम क्यूंग-जिन, किम क्यूंग-रन
एल्गोरिथम नवाचार: 10x से 100x सुधार क्षमता
एक कहानी है जिसे सैम ऑल्टमैन ओपनएआई सम्मेलन कक्ष में सबसे अधिक बार सामने लाते हैं।
"बड़े कंप्यूटर, अधिक जीपीयू। बेशक वे महत्वपूर्ण हैं, लेकिन जो चीज़ वास्तव में गेम को बदलती है वह एल्गोरिदम है।"
उन्होंने 2024 के अंत में इस संदेश को और भी मजबूती से देना शुरू किया। क्योंकि एआई उद्योग एक दीवार से टकरा रहा था। यह 'स्केलिंग की सीमा' थी।
जब तक हम GPT-3 से GPT-4 में नहीं चले गए तब तक यह सरल था। अधिक डेटा एकत्र करने और हजारों अधिक शक्तिशाली जीपीयू को जोड़ने से प्रदर्शन बढ़ गया। ठीक वैसे ही जैसे कार के इंजन में अधिक ईंधन डालने से वह तेज़ हो जाता है।
लेकिन 2024 में चीजें बदल गई हैं। कई एआई प्रयोगशालाओं ने एक ही समस्या की रिपोर्ट करना शुरू कर दिया। भले ही मॉडल का आकार दोगुना कर दिया गया, लेकिन प्रदर्शन में पहले जितना सुधार नहीं हुआ। यह तथाकथित 'स्केलिंग कानून का धीमा होना' था।
ऑल्टमैन ने किसी अन्य की तुलना में इस समस्या का पूर्वानुमान पहले ही लगा लिया था। इसलिए वह दूसरी दिशा में देखने लगा। यह एक 'एल्गोरिदमिक सफलता' थी।
"प्रदर्शन को 10 से 100 गुना तक बढ़ाने की क्षमता एल्गोरिथम नवाचार में निहित है।"
यह अतिशयोक्ति जैसा लग रहा था. हालाँकि, AI के इतिहास पर नज़र डालें तो यह पहले ही कई बार साबित हो चुका है।
एक प्रतिनिधि उदाहरण 'ट्रांसफॉर्मर' संरचना है जो 2017 में सामने आई थी। इस नए एल्गोरिदम के आगमन के साथ, हम समान कंप्यूटिंग संसाधनों का उपयोग करके बेहतर प्रदर्शन के आदेश प्राप्त करने में सक्षम थे। जो तकनीक चैटजीपीटी का आधार बनी वह यही ट्रांसफार्मर थी।
एक अन्य उदाहरण 'आरएलएचएफ, ह्यूमन फीडबैक से सुदृढीकरण सीखना' है। यह एकल तकनीक जीपीटी मॉडल को एक साधारण टेक्स्ट जनरेटर से एक स्मार्ट सहायक में बदल देती है जो मनुष्यों के साथ बातचीत कर सकता है।
ऑल्टमैन ने एक आंतरिक दस्तावेज़ में लिखा:
"हम पहले से ही कंप्यूटिंग की भौतिक सीमाओं के करीब पहुंच रहे हैं। अगर हम चीजों को वैसे ही बढ़ाते रहे जैसे हम अभी हैं, तो हम अंततः एक दीवार से टकराएंगे। जो चीज हमें उस दीवार से पार कराएगी वह पूरी तरह से नए तरह का एल्गोरिदम है।"
दिसंबर 2024 में, OpenAI ने 'o1' नामक एक नए अनुमान मॉडल की घोषणा की। यह मॉडल मौजूदा GPT से बिल्कुल अलग तरीके से काम करता है। तुरंत कोई उत्तर देने के बजाय, मैंने समस्या को कई चरणों में विभाजित किया और धीरे-धीरे इसके बारे में 'सोचा'।
परिणाम आश्चर्यजनक थे.
अंतर्राष्ट्रीय गणित ओलंपियाड समस्याओं में, o1 ने मानव स्वर्ण पदक विजेता के स्तर पर प्रदर्शन किया। इसने उन समस्याओं को हल कर दिया है जिन्हें मौजूदा GPT-4 हल नहीं कर सका था। इसके अलावा, उपयोग किए गए कंप्यूटिंग संसाधन GPT-4 को प्रशिक्षित करने की तुलना में बहुत कम थे।
यह एल्गोरिथम सफलता की शक्ति थी।
सैम ऑल्टमैन ने जनवरी 2025 में एक साक्षात्कार में कहा:
"सुपरइंटेलिजेंस के आगमन के साथ, वैज्ञानिक खोज की गति दस गुना तेज हो जाएगी। जिस तकनीकी प्रगति में 10 साल लगते थे, वह सिर्फ एक साल में हासिल हो जाएगी। और उस वर्ष में, उतनी ही प्रगति होगी। अगर यह जमा होता रहा, तो दुनिया पूरी तरह से बदल जाएगी।"
निस्संदेह, उन्होंने लोगों की अपेक्षाओं को तुरंत समायोजित कर दिया। "ट्विटर पर प्रचार बहुत ज्यादा है। अपनी अपेक्षाओं को सौवें हिस्से तक कम करें। हमने अभी तक एजीआई नहीं बनाया है।"
लेकिन मूल संदेश स्पष्ट था. एआई विकास में अगला कदम यह था कि यह एल्गोरिथम नवाचार से आया था, हार्डवेयर प्रतिस्पर्धा से नहीं।
वास्तव में, OpenAI के भीतर नए एल्गोरिदम पर शोध जोरों पर है।
शोधकर्ता 'चेन-ऑफ-थॉट' और 'ट्री-ऑफ-थॉट' जैसे नए तर्क पैटर्न विकसित कर रहे हैं। ये तकनीकें एआई को केवल भविष्यवाणी करने के बजाय वास्तव में एनईआर शब्द का 'अनुमान' लगाने की अनुमति देती हैं।
'विशेषज्ञों का मिश्रण (विशेषज्ञों का मिश्रण)' के बारे में अधिक जानें। यह विधि एक बड़े मॉडल के भीतर कई छोटे विशेषज्ञ मॉडल बनाती है, और जब कोई प्रश्न पूछा जाता है, तो केवल सबसे उपयुक्त विशेषज्ञ ही उत्तर देने के लिए जागृत होता है। और पढ़ें धन्यवाद.
इस तकनीक की बदौलत, समान प्रदर्शन प्रदान करते हुए आवश्यक कंप्यूटिंग संसाधनों को दसवें हिस्से तक कम किया जा सकता है।
ऑल्टमैन के मुख्य वैज्ञानिक जैकब पचॉकी ने समझाया:
"वर्तमान मॉडल लगभग पांच घंटे के कार्यों को संभाल सकते हैं, लेकिन इस बार विंडो का तेजी से विस्तार होगा। प्रमुख वैज्ञानिक सफलताओं के लिए, डेटा सेंटर की कंप्यूटिंग शक्ति को सिर्फ एक समस्या के लिए समर्पित करना सार्थक हो सकता है।"
कुंजी 'दक्षता' है.
मानव मस्तिष्क लगभग 20 वाट बिजली पर काम करता है। हम एक प्रकाश बल्ब को चालू करने के लिए बमुश्किल पर्याप्त ऊर्जा के साथ समस्याओं के बारे में सोचते हैं, बनाते हैं और उनका समाधान करते हैं। दूसरी ओर, GPT-4, एक उत्तर उत्पन्न करने के लिए बहुत अधिक शक्ति का उपयोग करता है।
इस अंतर को ख़त्म करना. यही एल्गोरिथम इनोवेशन का लक्ष्य है।
सैम अल्टमैन ने भविष्य को इस तरह चित्रित किया।
"एक दिन, हम ऐसे मॉडल चलाने में सक्षम होंगे जो आज की तुलना में 100 गुना अधिक स्मार्ट हैं, आज की तुलना में 100 गुना कम लागत पर। वह क्षण वास्तविक एआई क्रांति की शुरुआत होगी।"
हमारा मानना है कि यह सफलता सिर्फ एक तकनीकी उपलब्धि से कहीं अधिक है। कैंसर का इलाज खोजना, जलवायु परिवर्तन का समाधान करना, नए ऊर्जा स्रोत विकसित करना। मानवता के सामने आने वाली सबसे कठिन समस्याओं को एल्गोरिथम नवाचार के माध्यम से हल किया जा सकता है।
अक्टूबर 2025 में, ऑल्टमैन ने एक अधिक विशिष्ट समयरेखा की पेशकश की।
"हम सितंबर 2026 तक इंटर्न-स्तरीय एआई अनुसंधान सहायक तैयार करेंगे। और हम 2028 तक पूरी तरह से स्वचालित 'एआई शोधकर्ताओं' को पूरा कर लेंगे।"
ये एआई शोधकर्ता बिना किसी मानवीय निर्देश के अपने दम पर अनुसंधान परियोजनाएं चला सकते हैं। पेपर पढ़ें, परिकल्पनाएँ विकसित करें, प्रयोग डिज़ाइन करें और परिणामों का विश्लेषण करें। और सबसे महत्वपूर्ण बात. इस AI का उपयोग यह अध्ययन करने के लिए किया जा सकता है कि बेहतर AI कैसे बनाया जाए।
यह एल्गोरिथम नवाचार का स्व-त्वरक प्रभाव है।
एक बार जब एक अच्छा एल्गोरिदम बन जाता है, तो वह एक बेहतर एल्गोरिदम ढूंढ लेगा। तब विकास की गति तेजी से बढ़ती है।
बेशक, इसकी कोई गारंटी नहीं है कि यह सब सुचारू रूप से चलेगा।
एल्गोरिथम इनोवेशन में अभी भी कई चुनौतियाँ बनी हुई हैं। दीर्घकालिक तर्क, सुसंगत योजना और जटिल कारण-और-प्रभाव संबंधों को समझना। ये क्षमताएं अभी तक एआई द्वारा पूरी तरह से हासिल नहीं की गई हैं।
लेकिन सैम ऑल्टमैन आशावादी हैं।
"अब हम जानते हैं कि 90% मॉडल सीमाएँ एल्गोरिथम समस्याएं हैं। जिस क्षण आप उस बाधा को पार कर लेते हैं, एआई पूरी तरह से अलग तरह की चीज़ बन जाती है।"
उनका मानना है कि वह क्षण आपकी सोच से भी जल्दी आएगा। "कुछ हज़ार दिनों में," एक वाक्यांश है जिसका वह अक्सर उपयोग करते हैं। इसका मतलब लगभग 2030 के आसपास.
आख़िरकार, एल्गोरिथम संबंधी सफलताएँ केवल तकनीकी सुधार नहीं हैं। यह मानव-निर्मित बुद्धिमत्ता के भविष्य को नया स्वरूप देने के बारे में है। और सैम ऑल्टमैन भविष्य के दरवाजे के ठीक सामने है, चुपचाप लेकिन मजबूती से सीढ़ियों तक पहुंच रहा है।
एल्गोरिदम, डेटा और कंप्यूटिंग की पवित्र त्रिमूर्ति
एक रूपक है जिसका प्रयोग सैम ऑल्टमैन अक्सर करते हैं।
"एआई मॉडल खाना पकाने की तरह हैं। आपको एक अच्छी रेसिपी (एल्गोरिदम), ताज़ा सामग्री (डेटा), और एक अच्छी रसोई (कंप्यूटिंग) की आवश्यकता होती है। यदि एक भी गायब है, तो एक उचित डिश का उत्पादन नहीं किया जा सकता है।"
ये तीन तत्व एआई उन्नति के त्रिकोणीय स्तंभ हैं। OpenAI की सभी रणनीतियाँ इन तीन स्तंभों को संतुलित तरीके से मजबूत और विकसित करने पर ध्यान केंद्रित करती हैं।
पहला स्तंभ एल्गोरिथ्म
एल्गोरिदम एआई की 'मस्तिष्क संरचना' हैं।
सैम ऑल्टमैन एल्गोरिदम को "बुद्धि का खाका" कहते हैं। भले ही समान डेटा और समान कंप्यूटर का उपयोग किया जाए, यदि एल्गोरिदम भिन्न हैं, तो परिणाम काफी भिन्न हो सकते हैं।
जीपीटी सीरीज़ बनाते समय उन्होंने इस तथ्य को गहराई से महसूस किया।
जब GPT-3 सामने आया तो लोग हैरान रह गए. हालाँकि, OpenAI के भीतर कई लोगों ने कहा कि "अभी भी एक लंबा रास्ता तय करना बाकी है।" ऐसा इसलिए है क्योंकि मॉडल अक्सर गलत उत्तर देता है या संदर्भ खो देता है।
उस समय जो उभरा वह था आरएलएचएफ (मानव प्रतिक्रिया के माध्यम से सुदृढीकरण सीखना)। इस एक एल्गोरिदम ने GPT-3 को एक पूरी तरह से अलग इकाई में बदल दिया। यह वही मॉडल और वही डेटा था, लेकिन केवल सीखने का तरीका बदल गया और अचानक हम इंसानों की तरह बात करने में सक्षम हो गए।
ऑल्टमैन इस बिंदु पर आश्वस्त थे। "भविष्य का निर्माण बड़े मॉडलों से नहीं, बल्कि अधिक स्मार्ट एल्गोरिदम द्वारा किया जाएगा।"
OpenAI की अनुसंधान दिशा तब से स्पष्ट रूप से एल्गोरिथम नवाचार पर ध्यान केंद्रित करने लगी है। तर्क के नए तरीके, अधिक कुशल ध्यान तंत्र, दीर्घकालिक स्मृति के साथ संरचनाएं, और मनुष्यों की तरह सोचने के लिए वृक्ष-आधारित तर्क। यह सब एल्गोरिथम अनुसंधान का परिणाम था।
और 2024 के अंत में O1 मॉडल सामने आया। यह मॉडल 'सोचने के समय' को बढ़ाकर समस्याओं का समाधान करता है। जबकि मौजूदा मॉडलों ने तुरंत उत्तर देने का प्रयास किया, धीरे-धीरे, चरण दर चरण अनुमान लगाया गया।
परिणामस्वरूप, समान मात्रा में प्रशिक्षण डेटा के साथ इसने बहुत बेहतर प्रदर्शन किया। यह एल्गोरिथम नवाचार की शक्ति थी।
दूसरा स्तंभ डेटा
डेटा एआई का 'अनुभव' है।
सैम ऑल्टमैन डेटा को "पाठ्यपुस्तक जिसके माध्यम से मॉडल दुनिया को सीखते हैं" के रूप में वर्णित करते हैं। कोई फर्क नहीं पड़ता कि एल्गोरिदम कितना अच्छा है, खराब गुणवत्ता वाले डेटा के साथ सीखने का परिणाम बेकार एआई होगा।
"कचरा आया कचरा गया।" कंप्यूटर विज्ञान की एक पुरानी कहावत एआई के युग में और भी अधिक प्रासंगिक हो गई है।
GPT-3 बनाते समय, OpenAI ने इंटरनेट से बड़ी मात्रा में टेक्स्ट एकत्र किया। वेब पेज, ब्लॉग, फ़ोरम, किताबें, समाचार लेख। मैं हर तरह का लेखन करता हूं।
वहां एक समस्या थी। इंटरनेट केवल अच्छी जानकारी से भरा नहीं था। फर्जी खबरें, पक्षपातपूर्ण लेख, अपशब्द और घृणास्पद भाषण। ये बातें भी साथ-साथ सीखी गईं.
इसलिए GPT-4 से शुरुआत करते हुए, हमने डेटा की 'गुणवत्ता' पर ध्यान केंद्रित करना शुरू किया। बहुत सारा डेटा एकत्र करने के बजाय, हमने चुनिंदा रूप से मान्य, उच्च-गुणवत्ता वाले डेटा का उपयोग किया।
वैज्ञानिक कागजात, पेशेवर किताबें, विश्वसनीय समाचार स्रोत और सिद्ध शैक्षिक सामग्री। इन आंकड़ों ने मॉडल के प्रदर्शन में काफी सुधार किया।
ऑल्टमैन ने टीम से कहा: "एआई को दुनिया जैसा दिखना चाहिए, लेकिन दुनिया का सबसे अच्छा, सबसे खराब नहीं।"
एक और महत्वपूर्ण परिवर्तन डेटा की 'विविधता' था।
केवल पाठ ही पर्याप्त नहीं था. GPT-4 से शुरुआत करके, हमने कोड, गणितीय सूत्र, वैज्ञानिक डेटा, चिकित्सा प्रोटोकॉल और कानूनी दस्तावेज़ सहित विभिन्न प्रकार के डेटा सीखे।
फिर मॉडल के सोचने का तरीका बदल गया. अतीत में, हम केवल "प्रशंसनीय लेख" लिखने के स्तर पर थे, लेकिन अब हम वास्तव में समस्याओं को हल करने के स्तर पर हैं।
2024 के अंत से 'सिंथेटिक डेटा' भी महत्वपूर्ण हो जाएगा। यह सीधे AI द्वारा बनाया गया डेटा है। गणित की समस्याओं को हल करते समय ओ1 मॉडल द्वारा उत्पन्न अनुमान प्रक्रिया अगले मॉडल को प्रशिक्षित करने के लिए डेटा बन जाती है, इत्यादि।
इससे इंटरनेट से निकाले जा सकने वाले डेटा की सीमाएं बढ़ सकती हैं। एक अच्छा चक्र शुरू होता है जिसमें AI अपने आप बेहतर डेटा बनाता है।
तीसरा स्तंभ कंप्यूटिंग
कंप्यूटिंग एआई की 'मांसपेशियां' है।
एल्गोरिदम और डेटा कितने भी अच्छे क्यों न हों, अगर उन्हें चलाने के लिए कंप्यूटर नहीं है तो उनका कोई फायदा नहीं है।
सैम ऑल्टमैन कंप्यूटिंग के बारे में बहुत यथार्थवादी हैं। वह जानते हैं कि एआई को आगे बढ़ाने के लिए भारी मात्रा में कंप्यूटिंग शक्ति की आवश्यकता होगी। लेकिन साथ ही, हम जानते हैं कि यह अनंत नहीं है।
GPT-4 के प्रशिक्षण की लागत $100 मिलियन से अधिक होने का अनुमान है। इसमें से अधिकांश GPU लागत और बिजली लागत थी। यह एक ऐसा पैमाना है जिसे अधिकांश स्टार्टअप संभाल नहीं सकते।
इसलिए अल्टमैन दो दिशाओं में चले गए।
एक था अधिक कंप्यूटिंग बुनियादी ढांचे का अधिग्रहण करना। उन्होंने एक विशाल डेटा सेंटर बनाने के लिए माइक्रोसॉफ्ट के साथ साझेदारी की। 2025 में, 'स्टारगेट प्रोजेक्ट' की घोषणा की गई, जिसमें AI बुनियादी ढांचे में $500 बिलियन का निवेश करने की योजना थी।
दूसरा था कंप्यूटिंग का अधिक कुशलता से उपयोग करना। यहीं पर एल्गोरिथम नवाचार फिर से चलन में आता है। अधिक स्मार्ट एल्गोरिदम के साथ, वही कार्य कंप्यूटिंग की 1/10वीं मात्रा के साथ पूरा किया जा सकता है।
ऑल्टमैन अक्सर कहते हैं: "बुद्धि की कीमत अंततः ऊर्जा की कीमत के साथ मिल जाएगी।"
इसका मतलब क्या है?
वर्तमान में, एआई मॉडल बनाने में एल्गोरिदम विकास, डेटा संग्रह और इंजीनियर श्रम लागत सहित कई लागतें शामिल हैं। हालाँकि, भविष्य में, जब एल्गोरिदम पूरा हो जाएगा और पर्याप्त डेटा होगा, तो एकमात्र शेष लागत बिजली बिल होगी।
इसलिए वह ऊर्जा के मुद्दों पर बहुत अधिक ध्यान दे रहे हैं। परमाणु ऊर्जा, परमाणु संलयन, नवीकरणीय ऊर्जा। हमारा मानना है कि किफायती और स्वच्छ ऊर्जा हासिल करना एआई के विकास की कुंजी है।
तीन स्तंभों का सामंजस्य
महत्वपूर्ण बात यह है कि ये तीनों कारक एक-दूसरे को प्रभावित करते हैं।
जैसे-जैसे अच्छे एल्गोरिदम सामने आते हैं, आवश्यक डेटा की मात्रा कम हो जाती है और कम कंप्यूटिंग संसाधनों की आवश्यकता होती है। इसके विपरीत, अधिक कंप्यूटिंग शक्ति आपको अधिक जटिल एल्गोरिदम के साथ प्रयोग करने और अधिक डेटा संसाधित करने की अनुमति देती है।
सैम ऑल्टमैन का मानना है कि सीईओ के रूप में इन तीन तत्वों को संतुलित करना उनकी सबसे महत्वपूर्ण भूमिका है।
"यदि आप एल्गोरिदम पर बहुत अधिक ध्यान केंद्रित करते हैं, तो आप व्यावहारिक उत्पाद नहीं बना पाएंगे। यदि आप कंप्यूटिंग पर बहुत अधिक ध्यान केंद्रित करते हैं, तो दक्षता कम हो जाएगी। यदि आप डेटा पर बहुत अधिक ध्यान केंद्रित करते हैं, तो आप कानूनी और नैतिक मुद्दों में फंस जाएंगे।"
"संतुलन खोए बिना एक ही समय में इन तीन चीजों का विकास करना। OpenAI यही करता है।"
और यह भविष्य के लिए उनका दृष्टिकोण है:
"अगले 10 वर्षों में, एल्गोरिदम आज की तुलना में 100 गुना अधिक कुशल हो जाएंगे। सिंथेटिक डेटा की बदौलत डेटा अनंत हो जाएगा। नई चिप प्रौद्योगिकियों और सस्ती ऊर्जा की बदौलत कंप्यूटिंग बहुत अधिक शक्तिशाली हो जाएगी।"
"जब ये तीन पहिये एक साथ चलने लगते हैं, तभी असली जादू होता है।"
1 ट्रिलियन टोकन संदर्भ और वैयक्तिकृत आजीवन रिकॉर्ड एआई
एआई का अंतिम रूप क्या है जिसका सैम ऑल्टमैन सपना देखते हैं?
यह दुनिया का सबसे स्मार्ट AI नहीं है। वास्तव में, यह लगभग विपरीत है. "एआई जो सिर्फ आपके लिए है और आपको सबसे अच्छी तरह जानता है।"
उन्होंने इस दृष्टिकोण को एक वाक्य में संक्षेप में प्रस्तुत किया है:
"1 ट्रिलियन टोकन संदर्भों वाला एक बहुत छोटा अनुमान मॉडल।"
इस वाक्य में भविष्य के AI का सारा सार समाहित है।
1 ट्रिलियन टोकन क्या है?
सबसे पहले, आपको यह जानना होगा कि 'टोकन' क्या है।
भाषा को समझने के लिए AI के लिए टोकन मूल इकाई हैं। आप इसे मोटे तौर पर एक शब्द या छोटे टुकड़े के रूप में सोच सकते हैं। उदाहरण के लिए, "हैलो" में लगभग 2 या 3 टोकन होते हैं।
तो 1 ट्रिलियन टोकन कितने हैं?
हैरी पॉटर श्रृंखला के सभी संस्करणों की कीमत लगभग 1 मिलियन टोकन है। हैरी पॉटर को 1 मिलियन बार पढ़ने के लिए 1 ट्रिलियन टोकन पर्याप्त हैं। इसे दूसरे तरीके से कहें तो, इसमें वह सब कुछ समाहित करने के लिए पर्याप्त है जो एक व्यक्ति अपने पूरे जीवन में पढ़ता है, लिखता है और बोलता है।
'संदर्भ' एआई की 'मेमोरी' को संदर्भित करता है। अब हम जिस चैटजीपीटी का उपयोग कर रहे हैं वह बातचीत करते समय पहले कही गई बातों को भूल जाता है। ऐसा इसलिए है क्योंकि संदर्भ सीमित है.
2025 तक, सबसे बड़े संदर्भ वाला मॉडल लगभग 1 मिलियन टोकन का है। हालाँकि यह एक बड़ी राशि है, यह 1 ट्रिलियन टोकन का केवल 1/1000वाँ हिस्सा है।
एआई जो जीवनभर रिकॉर्ड याद रखता है
1 ट्रिलियन टोकन संदर्भ के साथ AI क्या कर सकता है?
आप अपने जन्म से लेकर अब तक सब कुछ याद कर सकते हैं।
जब मैं छोटा था तब लिखी गई डायरी, स्कूल में लिखा होमवर्क, दोस्तों के साथ बातचीत, नौकरी के लिए इंटरव्यू के दौरान कही गई बातें, काम के दौरान भेजे गए ईमेल, अपने परिवार के साथ यादें, स्वास्थ्य रिकॉर्ड, पसंदीदा संगीत और फिल्में, शौक, चिंताएं और सपने। एआई को यह सब याद रहता है।
सैम ऑल्टमैन इसे "व्यक्ति का दूसरा मस्तिष्क" कहते हैं।
इस प्रकार के AI से क्या संभव होगा?
जब आप सुबह उठते हैं, तो एआई कहता है: "आज एक महत्वपूर्ण प्रस्तुति दिवस है। क्या आपको वह गलती याद है जो आपने की थी क्योंकि आप पांच साल पहले इसी तरह की प्रस्तुति के दौरान घबरा गए थे? मुझे लगता है कि इस बार इस तरह तैयारी करना अच्छा होगा।"
जब आप स्वास्थ्य जांच के लिए जाएंगे तो एआई आपकी मदद करेगा। "यदि आप 10 वर्षों के अपने स्वास्थ्य इतिहास को देखें, तो वर्ष के इस समय के आसपास आपका रक्तचाप थोड़ा अधिक हो जाता है। पिछले वर्ष आपने जो व्यायाम विधि आज़माई थी, वह अच्छी रही, तो इसे दोबारा क्यों न आज़माएँ?"
जब आप कोई नया प्रोजेक्ट शुरू करने वाले होते हैं तो AI आपको सलाह देता है। "आपने तीन साल पहले इसी तरह का एक विचार लिखा था। मैं उस समय इसे लागू करने में सक्षम नहीं था, लेकिन मुझे लगता है कि अब स्थिति अलग है। मुझे लगता है कि मैंने जो तब लिखा था और जो मैं अब सोचता हूं उसे मिला दूं तो एक अच्छी योजना सामने आएगी।"
यह 'पूर्णतः वैयक्तिकृत AI' जैसा दिखता है।
यह एक 'छोटा' मॉडल क्यों होना चाहिए?
यहां एक महत्वपूर्ण मोड़ है.
सैम ऑल्टमैन का कहना है कि यह AI एक "बहुत छोटा मॉडल" होना चाहिए। इसका अर्थ क्या है?
GPT-4 जैसे मौजूदा मॉडल बहुत बड़े हैं। यह केवल विशाल डेटा केंद्रों में चलता है। हालाँकि, जिस वैयक्तिकृत AI का ऑल्टमैन सपना देखता है वह आपके स्मार्टफोन के अंदर चलना चाहिए।
क्यों?
सबसे पहले, गोपनीयता के कारण.
अपने जीवन के रिकॉर्ड को इंटरनेट पर भेजना और उन्हें किसी दूरस्थ सर्वर पर संसाधित करना जोखिम भरा है। आपको हैक किया जा सकता है, या कोई कंपनी आपकी जानकारी का उपयोग बुरे उद्देश्यों के लिए कर सकती है।
लेकिन क्या होगा यदि सारी प्रोसेसिंग आपके डिवाइस पर हो? कोई भी आपकी जानकारी तक नहीं पहुंच सकता. पूर्ण गोपनीयता की गारंटी है.
दूसरा, गति के कारण.
इंटरनेट पर डेटा भेजने और प्राप्त करने में समय लगता है। लेकिन अगर यह सीधे आपके फ़ोन पर किया गया है, तो आपको तुरंत उत्तर मिल जाएगा। यह उतना ही तेज है जितना मैं अपने दिमाग में सोच रहा हूं।
तीसरा, लागत के कारण.
एक विशाल सर्वर को बनाए रखने में बहुत पैसा खर्च होता है। हालाँकि, छोटे मॉडल बहुत सस्ते होते हैं यदि वे अपने डिवाइस पर चलते हैं।
"लेकिन क्या एक छोटा मॉडल स्मार्ट हो सकता है?"
यह एक अच्छा सवाल है। यहाँ सैम ऑल्टमैन का उत्तर है:
"निजीकरण मॉडल को दुनिया को जानने की ज़रूरत नहीं है। इसे बस एक व्यक्ति की गहरी समझ की आवश्यकता है। इसलिए भले ही यह छोटा है, यह शक्तिशाली हो सकता है।"
इसके बारे में सोचो. एक छोटा एआई जो आपके स्वाद, आदतों, लक्ष्यों, शक्तियों और कमजोरियों को पूरी तरह से जानता है, और एक विशाल एआई जो दुनिया की हर चीज के बारे में थोड़ा-थोड़ा जानता है। कौन सा आपके जीवन के लिए अधिक उपयोगी है?
यह कैसे संभव है?
बेशक, इनमें से कुछ भी आसान नहीं है।
2025 में, वर्तमान तकनीक अभी भी इसे पूरी तरह से लागू नहीं कर सकती है। लेकिन टुकड़े एक-एक करके एक साथ आ रहे हैं।
एल्गोरिदमिक नवाचारों ने प्रदर्शन को बनाए रखते हुए मॉडल को छोटा बनाना संभव बना दिया है। 'मॉडल कंप्रेशन' तकनीक में प्रगति के साथ, एक विशाल मॉडल को उसके आकार के 1/10वें हिस्से तक कम करने से वस्तुतः कोई प्रदर्शन हानि नहीं होगी।
दीर्घकालिक स्मृति तकनीक भी आगे बढ़ रही है। सभी सूचनाओं को हर समय याद रखने के बजाय, केवल महत्वपूर्ण चीज़ों को संग्रहीत करने और ज़रूरत पड़ने पर उन्हें तुरंत पुनर्प्राप्त करने के तरीके विकसित किए जा रहे हैं।
ऑन-डिवाइस AI चिप्स भी तेजी से विकसित हो रहे हैं। Apple का न्यूरल इंजन, क्वालकॉम का AI प्रोसेसर। जैसे-जैसे ये चिप्स अधिक शक्तिशाली होते जाते हैं, स्मार्टफ़ोन भी जटिल AI मॉडल चला सकते हैं।
भविष्य कैसा दिखता है
सैम ऑल्टमैन अब से 10 वर्षों के भविष्य की कल्पना इस प्रकार करते हैं।
"2035 तक, अधिकांश लोगों के पास अपना निजी एआई होगा जो जन्म से आपके साथ बढ़ेगा, आपके हर पल को याद रखेगा और जीवन भर आपकी मदद करेगा।"
"यह सिर्फ एक सहायक से कहीं अधिक होगा। यह आपका बाहरी मस्तिष्क, आपका सबसे अच्छा दोस्त और आपका सबसे बुद्धिमान सलाहकार होगा।"
"और सबसे महत्वपूर्ण बात, एआई पूरी तरह से आपका है। इस तक किसी की पहुंच नहीं है, केवल आप ही इसे नियंत्रित कर सकते हैं।"
यह एआई का भविष्य है जिसका सैम ऑल्टमैन सपना देखते हैं।
ऐसा भविष्य नहीं जहां एक विशाल सुपर एआई दुनिया पर राज करता है, बल्कि ऐसा भविष्य जहां हर किसी के पास अपना आदर्श एआई भागीदार हो। उनका मानना है कि यह अधिक सुंदर, अधिक मानवीय और अधिक सुरक्षित भविष्य है।
"एआई इंसानों की जगह नहीं ले रहा है। यह प्रत्येक इंसान को अधिक शक्तिशाली बना रहा है।"
ट्रिलियन टोकन संदर्भ वाले एक छोटे अनुमान मॉडल का वास्तव में यही मतलब है।
Kim Kyung-jin
वकील, पूर्व नेशनल असेंबली सदस्य, एआई नीति शोधकर्ता
© 2026 Kim Kyung-jin. All rights reserved.