Bản tiếng Việt · Sách mới
Trí tuệ nhân tạo trong nông nghiệp làm vườn
Luật sư Kim Kyung-jin
Qua 5 chương và 10 mục, cuốn sách giải thích thị giác máy tính để chẩn đoán sâu bệnh, robot thu hoạch, nhà kính thông minh, tưới chính xác, quản lý chất lượng, định kiểu hình thông lượng cao và chọn giống dự báo.
Mục lục
Trí tuệ nhân tạo dịch ngôn ngữ của loài vật
Luật sư Kim Kyung-jin
Câu chuyện về AI học cách lắng nghe tiếng cá voi, cá heo, chim và ong
Mười hai chương về cách trí tuệ nhân tạo lắng nghe cá heo, cá nhà táng, cá voi lưng gù, chim và ong để tìm ra quy luật trong âm thanh của chúng, cùng những rủi ro và vấn đề quyền động vật mà công nghệ này đặt ra. Viết bằng những câu đơn giản mà trẻ em cũng đọc được, mỗi phần đều kèm tài liệu tham khảo đã kiểm chứng.
Mục lục
AI giải mã chữ viết cổ đại
Luật sư Kim Kyung-jin
Ghi chép cổ được AI hồi sinh
Trong mười hai chương, cuốn sách trình bày cách AI khôi phục những ghi chép từng không thể đọc, từ cuộn giấy cháy, mảnh gỗ vùi trong bùn đến bảng đất sét vỡ. Sách bàn về mở cuộn ảo ở Herculaneum, sắp xếp ảo văn tự giáp cốt, đọc thẻ gỗ Silla, phân tích tính toán các chữ viết chưa giải mã và kho lưu trữ đa phổ, kèm tài liệu tham khảo đã kiểm chứng ở từng chương.
Mục lục
Trí tuệ nhân tạo cho thiết kế vật liệu mới và kỹ thuật động cơ đẩy tên lửa
Luật sư Kim Kyung-jin
Thế năng AI, phòng thí nghiệm tự hành và học máy dựa trên vật lý (PIML)
Mười chương về cách trí tuệ nhân tạo thay đổi vật liệu mới và động cơ đẩy tên lửa: mô phỏng nguyên tử, mô hình sinh, phòng thí nghiệm tự hành, hợp kim chịu nhiệt, in 3D kim loại, tính toán cháy, thiết kế làm mát, chẩn đoán và điều khiển động cơ. Không dùng công thức, mỗi chương kèm tài liệu tham khảo đã kiểm chứng.
AI Library
Kỷ nguyên khám phá khoa học tự chủ
Kim Kyung-jin, Luật sư
Các nhà khoa học AI và phòng thí nghiệm tự lái
Cuốn sách này theo dõi cách các nhà khoa học AI và phòng thí nghiệm tự lái đang thay đổi cách khoa học tạo ra và kiểm chứng các tuyên bố. Nội dung bao gồm khám phá dựa trên tài liệu, chuyển đổi quy trình ngôn ngữ tự nhiên thành lệnh robot, hệ thống nghiên cứu đa tác nhân, phòng thí nghiệm vòng kín, tìm kiếm vật liệu, khoảng cách kiểm chứng, chuỗi bằng chứng, khung kiểm chứng nghiên cứu, đạo đức tạp chí và trách nhiệm pháp lý.
Mục lục
Những con người đã thay đổi khoa học bằng trí tuệ nhân tạo
Luật sư Kim Kyung-jin
Hành trình từ dữ liệu đến giải Nobel
Cuốn sách đi theo mười một nhà khoa học đã đưa trí tuệ nhân tạo vào trung tâm của khám phá khoa học, từ gấp protein, phát hiện thuốc mới, phòng thí nghiệm tự hành, nhà khoa học máy, máy đọc bài báo, đến câu hỏi ai sở hữu một phát hiện do máy tạo ra.
Bản tiếng Việt · Sách mới
Kỷ Nguyên Mới của Khoa Học Đời Sống do Trí Tuệ Nhân Tạo Mở Ra
Luật sư Kim Kyung-jin
Từ Proteomics Cấu Trúc Đến Mô Hình Nền Tảng Bộ Gene, Phòng Thí Nghiệm Tự Hành Và Quản Trị Toàn Cầu
Qua 14 chương và 31 mục, cuốn sách phân tích toàn diện cuộc cách mạng AI sinh học: dự đoán cấu trúc protein AlphaFold3, thiết kế de novo kháng thể, mô hình nền tảng bộ gene Evo2, phòng thí nghiệm tự hành và quản trị an toàn sinh học toàn cầu.
Bản tiếng Việt · Sách mới
Khai thác máy tính hiệu quả hơn 1.000% cùng tác nhân AI
Luật sư Kim Kyung-jin
24 cách thực tế để thay đổi đời sống và công việc bằng tác nhân AI
Cuốn sách hướng dẫn cách vượt qua những lúc máy tính trở nên khó dùng bằng cách làm việc cùng tác nhân AI: từ cài đặt và cuộc trò chuyện đầu tiên, giao việc an toàn, sắp xếp tệp và sao lưu tự động, xử lý ảnh, PDF và video, đến phím tắt, công cụ theo dõi, tìm nguyên nhân máy chậm, hồi sinh máy cũ, đọc thông báo lỗi và sắp xếp môi trường làm việc, qua 24 chương.
AI Library
Cấu trúc kép của chủ quyền số
Cuộc thoát khỏi Palantir của Châu Âu và xiềng xích Big Tech Mỹ
Luật sư Kim Kyung-jin, Luật sư
Đây là ghi chép về năm 2026, thời điểm các cơ quan tình báo và bộ quốc phòng châu Âu bắt đầu loại bỏ các công cụ phân tích của Palantir (Mỹ). Cuốn sách đề cập đến quyết định thay thế của Tổng cục An ninh Nội địa Pháp, Cơ quan Bảo vệ Hiến pháp Đức và Bộ Quốc phòng Hà Lan; vụ việc kiểm soát xuất khẩu của Mỹ cắt đứt quyền truy cập trí tuệ nhân tạo của các nước đồng minh chỉ trong ba ngày; cùng thực tế về quyền tài ph…
Bản tiếng Việt · Sách mới
Ứng dụng trí tuệ nhân tạo trong nông nghiệp cây lương thực
Luật sư Kim Kyung-jin
Sáu chương và 18 phần giải thích hạ tầng nông nghiệp số, giám sát cây trồng chính xác, dự báo sinh trưởng, chọn giống phân tử bằng AI, quyết định tự động, nông nghiệp thông minh thích ứng khí hậu và an ninh lương thực toàn cầu.
Mục lục
Chăn nuôi thông minh: Trí tuệ nhân tạo bước vào chuồng trại
Luật sư Kim Kyung-jin
Cảm biến lắng nghe, camera quan sát, trí tuệ nhân tạo hỗ trợ quyết định
Cuốn sách gồm 5 chương và 15 mục, theo dõi cách cảm biến, camera, micro, thiết bị đeo và trí tuệ nhân tạo đi vào thực tế chăn nuôi: sức khỏe, sinh sản, dinh dưỡng, vắt sữa bằng robot, hàng rào ảo, bản sao số, giảm methane, phúc lợi động vật và quyền sở hữu dữ liệu.


Toàn văn bản thảo
Tái thiết kế tổ chức AI
Luật sư Kim Kyung-jin
Tái thiết kế toàn diện cách làm việc và vận hành tổ chức trong kỷ nguyên tác nhân AI
Toàn bộ bản thảo nằm trong một bài: lời nói đầu, sáu chương và bài kết. Quy tắc 10:20:70, tổ chức giống cơ thể sống, tài năng mới ở nơi làm việc, thái độ của người lãnh đạo và chiến lược mở rộng thử nghiệm nhỏ ra toàn công ty.
16 bài công khai
2026 Bắc Kinh: Vũ điệu nguy hiểm của hai gã khổng lồ
Mục lục, lời mở đầu, 13 chương, lời kết.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
27 bài công khai
Giao việc cho AI rồi rời khỏi bàn
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
41 bài công khai
Làm chủ Claude Code
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
43 bài công khai
Máy bay chiến đấu AI, không quân AI
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
39 bài công khai
Chiến tranh Mỹ-Iran 2026 và khủng hoảng năng lượng toàn cầu
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
26 bài công khai
Trí tuệ nhân tạo AI ra trước tòa
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
24 bài công khai
Hành trình lịch sử và văn hóa Georgia
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
23 bài công khai
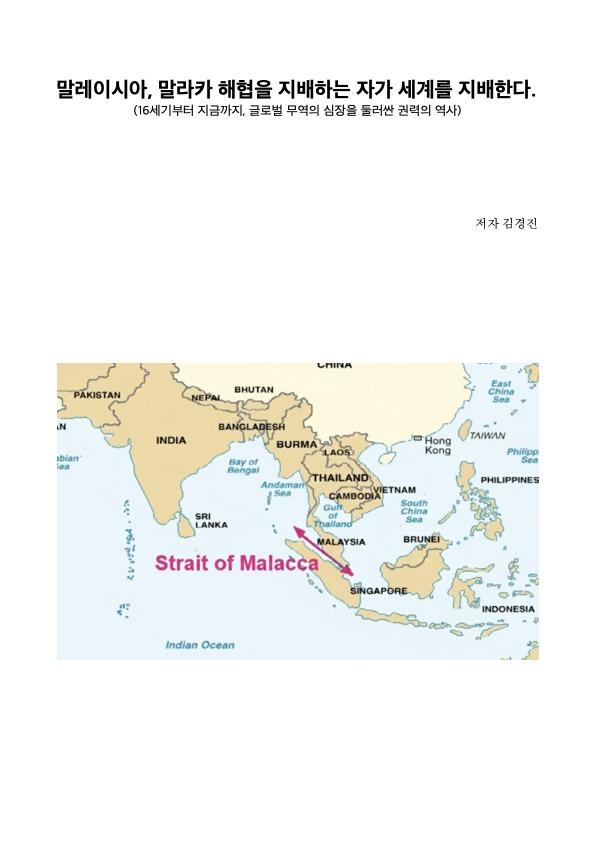
Malaysia: Ai kiểm soát eo biển Malacca sẽ kiểm soát thế giới
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
16 bài công khai
PALANTIR: AI chiến tranh và giám sát
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
21 bài công khai
Những người đọc bộ não
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
16 bài công khai
Biến đổi cấu trúc xã hội do AI và cách ứng phó
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
13 bài công khai
Một nghìn lời cầu nguyện, một ngọn núi: đọc Armenia
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
11 bài công khai
Sổ tay sử dụng Claude Cowork và tác nhân AI
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
12 bài công khai
10 câu hỏi AI đặt ra cho con người
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
14 bài công khai
Cuộc bầu cử trí tuệ nhân tạo
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
10 bài công khai
7 hiểu lầm về Tuyến đường hàng hải Bắc Cực
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
24 bài công khai
Nano Banana Pro Promptbook thực chiến
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
28 bài công khai
Kinh Pháp Cú 423 kệ ngôn
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
16 bài công khai
Công việc pháp lý và Trí tuệ nhân tạo
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
25 bài công khai
Chính trị và Con người
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
39 bài công khai
Câu chuyện Han Dong-hoon
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
34 bài công khai
Demis Hassabis, cha đẻ AI của Google
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
39 bài công khai
Vượt qua trần kính
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
13 bài công khai
Những dấu ấn mà Han Dong-hoon đã để lại tại Hàn Quốc
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
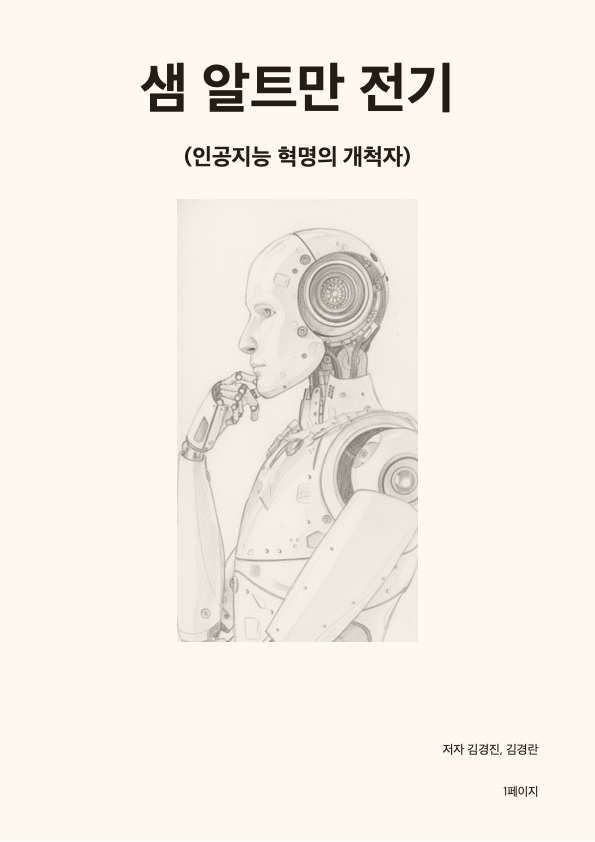
22 bài công khai
Tiểu sử Sam Altman: Người tiên phong của cuộc cách mạng AI
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
16 bài công khai
Câu chuyện Jensen Huang
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
13 bài công khai
Từ Chaiwala đến Thủ tướng
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
10 bài công khai
Xin chào. Tôi là Kim Kyung-jin
Mục lục và các chương được sắp xếp để đọc tuần tự.
Sách trực tuyến trong Thư viện AI của Kim Kyung-jin. Người đọc có thể mở mục lục và đọc từng chương bằng tiếng Việt.
Chương 1 Dữ liệu đào tạo AI tạo sinh và tranh chấp bản quyền
Trí tuệ nhân tạo AI, đứng trước tòa án
Phần 1: Sự xung đột giữa AI và Quyền sở hữu trí tuệ
Chương 1 Dữ liệu đào tạo AI tạo sinh và tranh chấp bản quyền
Luật sư Kim Kyung-jin
a. Cuộc chiến toàn diện giữa các cơ quan báo chí và doanh nghiệp AI
Tối ngày 27 tháng 12 năm 2023, các luật sư thuộc đội ngũ pháp lý tại trụ sở chính của The New York Times đã nộp đơn kiện lên Tòa án Liên bang khu vực phía Nam Manhattan, sau nhiều tháng chuẩn bị. Đó là một tài liệu dài 69 trang. Trong đó chứa đựng một bằng chứng kỳ lạ. Một bài báo điều tra đoạt giải Pulitzer của The New York Times được đặt ở bên trái, và văn bản do ChatGPT tạo ra được đặt ngay bên phải. Hai bài viết giống nhau đến mức kinh ngạc. Từ nhịp điệu của câu văn, cách lựa chọn từ ngữ, cho đến cả vị trí của các dấu phẩy.
(1) New York Times v. OpenAI/Microsoft: Tranh cãi về việc học máy trái phép nội dung tin tức và thay thế thị trường
Các luật sư của New York Times gọi hiện tượng này là 'regurgitation' (trào ngược). Điều đó có nghĩa là AI không thể tiêu hóa được dữ liệu đã học mà nôn ngược chúng ra nguyên trạng. Các bằng chứng trong đơn kiện là những trường hợp ChatGPT cung cấp các đoạn trích gần như hoàn hảo từ các bài báo yêu cầu đăng ký trả phí. Lập luận của New York Times rất đơn giản: Các người đã sao chép các bài báo của chúng tôi. Hàng triệu bản.
Có một khái niệm gọi là Sử dụng hợp lý (Fair Use). Nói một cách đơn giản là thế này: Việc đọc sách trong thư viện thì không sao, nhưng việc sao chép nguyên cả cuốn sách để đem bán là không được phép. Việc sinh viên trích dẫn sách vào bài báo cáo là được cho phép, nhưng việc lập nhà xuất bản để in ấn lại chính cuốn sách đó là một tội ác. Luật bản quyền sẽ phân định ranh giới này dựa trên bốn tiêu chí: Mục đích sử dụng có mang tính thương mại hay không. Tính chất của tác phẩm gốc như thế nào. Sử dụng bao nhiêu phần của tác phẩm. Và việc sử dụng đó có thay thế cho thị trường của tác phẩm gốc hay không.
The New York Times đã nhấn mạnh tiêu chí thứ tư. Thay thế thị trường.
Thay vì truy cập vào trang web của New York Times, mọi người đang hỏi ChatGPT. ChatGPT đưa ra câu trả lời dựa trên các bài báo của New York Times. Khi đã nghe được câu trả lời đó, người ta không còn nhu cầu phải đăng ký thuê bao New York Times nữa. Điều này giống như việc một cửa hàng y hệt xuất hiện ngay trước cửa tiệm của tôi và khiến khách hàng chuyển sang đó.
OpenAI cũng đã đưa ra những phản bác. Họ cho rằng mình không sao chép mà là đang 'học hỏi'. Việc AI học tập không khác gì cách một tác giả con người đọc hàng nghìn cuốn sách để tạo ra văn phong riêng của chính mình. Những bằng chứng về sự sao chép chỉ là những kết quả bất thường có được do việc cố tình thao túng mô hình. Vào tháng 4 năm 2025, Thẩm phán Sidney Stein của Tòa án Liên bang miền Nam New York đã bác bỏ hầu hết các lập luận của OpenAI. Ông quyết định sẽ tiến hành xét xử đối với các cáo buộc vi phạm bản quyền cốt lõi. Tuy nhiên, cuộc chiến thực sự đã nổ ra trong giai đoạn cung cấp chứng cứ (Discovery). Ban đầu, tờ New York Times đã yêu cầu 1,4 tỷ bản nhật ký trò chuyện của ChatGPT. OpenAI đã phản đối quyết liệt với lý do rằng điều này xâm phạm quyền riêng tư của người dùng.
Tháng 11 năm 2025, thẩm phán Ona T. Wang đã ra lệnh cho OpenAI phải nộp 20 triệu bản nhật ký trò chuyện đã được ẩn danh. Vào tháng 12, OpenAI đã yêu cầu xem xét lại nhưng đã bị bác bỏ. Tháng 1 năm 2026, thẩm phán đã chính thức xác nhận lệnh này. Lập luận của tòa án rất rõ ràng.
Nó không giống như việc nghe lén bất hợp pháp. Những lo ngại về quyền riêng tư đã được bảo vệ đầy đủ thông qua việc ẩn danh và các lệnh bảo vệ.
Vụ kiện này hiện đang được tiến hành dưới hình thức vụ kiện đa khu vực (MDL), hợp nhất từ 16 vụ kiện bản quyền khác nhau. Các cơ quan truyền thông lớn như New York Times, Chicago Tribune và Daily News đều đang tham gia với tư cách là nguyên đơn.
Để tham khảo, có thể nói một cách đơn giản rằng kiện tụng đa quận (MDL) là 'hệ thống quản lý tích hợp các vụ kiện'.
Vấn đề sẽ phát sinh khi hàng loạt vụ kiện với lý do tương tự nhắm vào cùng một bị cáo đổ dồn về từ khắp nơi trên cả nước. Nếu mười tòa án khác nhau tiến hành xét xử riêng biệt, kết quả có thể sẽ khác nhau, gây lãng phí thời gian và chi phí.
Năm 1968, Quốc hội Hoa Kỳ đã tạo ra một giải pháp. Ủy ban Phân phối Đa khu vực (JPML) sẽ tập hợp các vụ kiện tương tự về cùng một tòa án. Việc cung cấp chứng cứ và thẩm lý các vấn đề chung sẽ được xử lý cùng một lúc. Vụ kiện bản quyền của OpenAI là một ví dụ điển hình. 16 vụ kiện, bao gồm New York Times, Chicago Tribune, v.v., đã được hợp nhất về Tòa án Quận Nam New York. Một thẩm phán sẽ đưa ra phán quyết cho câu hỏi cốt lõi: "Việc huấn luyện AI có phải là sử dụng hợp lý hay không?"
Hiệu quả thực sự của MDL chính là khả năng thương lượng. Khi các đơn kiện tập hợp lại, sức mạnh sẽ lớn hơn. Đối với bị đơn, việc đạt được một thỏa thuận chung sẽ tốt hơn là phải chiến đấu trên khắp cả nước. Chính vì vậy, hầu hết các vụ kiện MDL đều kết thúc bằng thỏa thuận trước khi xét xử. Hiện nay, khoảng 60% các vụ kiện dân sự liên bang tại Hoa Kỳ được tiến hành theo hình thức MDL. Các vụ kiện về amiăng, opioid và rò rỉ dữ liệu đều đã đi theo lộ trình này. Giờ đây, các tranh chấp bản quyền AI cũng đã gia nhập vào hàng ngũ đó.
Phán quyết vẫn chưa được đưa ra, nhưng thị trường đã bắt đầu chuyển động. Một số cơ quan truyền thông đã bắt đầu ký kết hợp đồng cấp phép với OpenAI thay vì theo đuổi các vụ kiện tụng. Họ đã chọn dòng tiền ngay lập tức thay vì một chiến thắng không chắc chắn tại tòa án.
(2) Thomson Reuters v. ROSS Intelligence: Bác bỏ lập luận về sử dụng hợp lý trong việc sao chép trái phép cơ sở dữ liệu pháp luật
Trang đầu tiên của bản án từ Tòa án Liên bang Delaware đã gióng lên hồi chuông cảnh báo cho ngành công nghiệp AI.
Vào ngày 11 tháng 2 năm 2025, Thẩm phán Stephanos Bibas đã phán quyết rằng hành vi của công ty khởi nghiệp AI ROSS Intelligence trong việc sao chép trái phép các bản tóm tắt án lệ (headnotes) từ cơ sở dữ liệu pháp lý trả phí 'Westlaw' của Thomson Reuters để sử dụng cho việc huấn luyện AI không thuộc phạm vi sử dụng hợp lý (fair use).
Headnote không phải là bản thân bản án, mà gần giống như một 'thẻ tóm tắt' do biên tập viên tổng hợp các ý chính của phán quyết. Thomson Reuters đã tích lũy những bản tóm tắt này trong suốt nhiều thập kỷ. Ross Intelligence đã cố gắng tận dụng chúng để tạo ra một 'luật sư robot'.
Có hai căn cứ để thẩm phán Vivas đưa ra phán quyết.
Thứ nhất, mục đích học máy AI của Ross là để tạo ra một sản phẩm thương mại cạnh tranh trực tiếp với Thomson Reuters.
Thứ hai, khó có thể xem mô hình AI của Ross đã biến đổi tác phẩm gốc sang một mục đích hoặc ý nghĩa mới. Việc tự ý lấy dữ liệu của đối thủ cạnh tranh để tạo ra một sản phẩm cạnh tranh có tính năng tương tự không thể được bảo hộ dưới hình thức sử dụng hợp lý (fair use).
Có một lý do khiến phán quyết này trở nên quan trọng. Bởi nó đã phá vỡ mô hình của Thung lũng Silicon vốn cho rằng "việc huấn luyện AI mặc nhiên là sử dụng hợp lý". Tòa án đã xem xét trọng yếu hơn việc liệu sản phẩm đầu ra có phải là một sản phẩm cạnh tranh nhắm trực tiếp vào thị trường của nguyên đơn hay không, thay vì chỉ đơn thuần là sự thật rằng 'máy móc đã đọc dữ liệu'. Đây là một lời cảnh báo lạnh lùng dành cho các doanh nghiệp AI.
(3) Sự cố Perplexity AI: Công nghệ RAG và việc vi phạm nội dung thời gian thực
Vào cuối năm 2024, một loại hình trí tuệ nhân tạo mới đã xuất hiện. Đó chính là Perplexity AI.
Được tạo ra bởi các kỹ sư từng làm việc tại Google, dịch vụ này thay vì hiển thị kết quả tìm kiếm dưới dạng các đường liên kết, sẽ tóm tắt nội dung và đưa ra câu trả lời trực tiếp. Nó hướng tới việc trở thành một "Công cụ trả lời (Answer Engine)".
Đối với người dùng, điều này rất tiện lợi. Bạn không cần phải truy cập vào các trang web của các cơ quan báo chí vốn đầy rẫy quảng cáo.
Có một công nghệ được gọi là RAG (Retrieval-Augmented Generation, Tạo lập tăng cường truy xuất).
Nó giống như việc một đầu bếp không hề học thuộc lòng công thức, mà mỗi khi có khách gọi món, họ lại lấy công thức từ giá sách bên cạnh rồi tóm tắt lại ngay tại chỗ. Vấn đề nằm ở chỗ, giá sách đó có thể là một kệ sách trả phí của người khác.
Tháng 10 năm 2024, Dow Jones, đơn vị xuất bản của Wall Street Journal và New York Post, đã đệ đơn kiện Perplexity. Đến tháng 12 năm 2025, New York Times cũng đã tham gia vào vụ kiện này.
Có ba lập luận từ phía nguyên đơn.
Perplexity đã vượt qua được tường phí (Paywall) của các gói đăng ký trả phí.
Đã phớt lờ quy tắc chống cào dữ liệu (robots.txt) của trang web.
Bằng cách trích dẫn gần như nguyên vẹn nội dung bài báo, người dùng sẽ không cần phải nhấp vào liên kết gốc của bài viết nữa.
Vụ kiện của Chicago Tribune đã thêm vào một điều nữa.
Nội dung cho rằng Perplexity đã thông qua hiện tượng 'ảo giác' (Hallucination) để trích dẫn sai sự thật các nội dung không do các cơ quan báo chí viết, nhưng lại khiến người đọc lầm tưởng đó là tin tức từ chính các cơ quan báo chí đó. Vấn đề này thậm chí còn bao gồm cả việc làm loãng thương hiệu và bôi nhọ danh dự. Vụ việc này đang thử thách ranh giới giữa việc huấn luyện (training) và hiển thị (display) theo thời gian thực.
Nếu AI trong quá khứ học từ các dữ liệu cũ, thì AI hiện nay đang đọc và tóm tắt nội dung của người khác theo thời gian thực. Liệu chúng ta nên coi đây là sự 'tham chiếu' hay là 'đánh cắp nội dung theo thời gian thực'. Câu trả lời cho câu hỏi này sẽ quyết định toàn bộ mô hình kinh doanh của AI dạng tìm kiếm.
Cuộc chiến toàn diện giữa các cơ quan báo chí và các doanh nghiệp AI cuối cùng chính là một nỗ lực nhằm tái cấu trúc dòng chảy của tiền bạc. Đó là cuộc kéo co giữa phần lợi nhuận mà người tạo ra thông tin xứng đáng được hưởng, và phần lợi nhuận mà các công ty công nghệ – những bên xử lý và truyền tải thông tin đó – sẽ nắm giữ. Và mặt trận tiếp theo của cuộc chiến này đang diễn ra tại tòa án của các tác giả.
Tính đến tháng 1 năm 2026, các vụ kiện tụng xoay quanh Perplexity AI đang trở nên gay gắt hơn.
Tiền tuyến tiên phong nhất chính là Dow Jones.
Vụ kiện do công ty mẹ của Wall Street Journal và New York Post khởi xướng vào tháng 10 năm 2024 hiện đã bước vào giai đoạn tranh tụng về chứng cứ một cách quyết liệt.
Vào ngày 21 tháng 8 năm 2025, Thẩm phán Catherine Polke Phila đã bác bỏ cả đơn yêu cầu bác bỏ vụ kiện lẫn đơn yêu cầu chuyển đổi thẩm quyền xét xử của Perplexity. Một công ty có văn phòng tại New York, thuê nhân viên và đặt biển quảng cáo tại Times Square không thể né tránh thẩm quyền của tòa án New York.
Thực tế, thời hạn kết thúc giai đoạn xác minh sự thật (Fact Discovery) đã được ấn định vào ngày 4 tháng 6 năm 2026.
Hiện tại, luật sư của cả hai bên đang yêu cầu cung cấp tài liệu, triệu tập nhân chứng và tìm kiếm điểm yếu của đối phương. Phía Dow Jones đang yêu cầu công khai mã nguồn của Perplexity. Perplexity đang từ chối, bởi vì bên trong mã nguồn này chứa đựng cách thức hệ thống RAG thực sự xử lý nội dung như thế nào.
Ngày 5 tháng 12 năm 2025, hai vụ kiện mới đã được đệ trình gần như cùng một lúc. New York Times và Chicago Tribune. Đơn kiện của New York Times còn nhấn mạnh thêm một điều nữa. Không chỉ là bản quyền, mà còn là quyền thương hiệu.
Vi phạm Đạo luật Lanham (Lanham Act). Logic ở đây là thế này: Perplexity đã tạo ra thông tin sai lệch nhưng lại đính kèm logo của New York Times ngay bên cạnh. Cứ như thể chính New York Times đã đưa tin như vậy. Đây là hành vi làm tổn hại đến giá trị thương hiệu. Lập luận cho rằng uy tín của một tờ báo 170 năm tuổi đang bị hủy hoại bởi hiện tượng ảo giác của AI.
Đã có một quyết định tố tụng đầy thú vị. Thẩm phán phụ trách vụ việc Dow Jones đã từ chối hợp nhất vụ việc New York Times thành một "vụ án liên quan". Vụ việc New York Times đã được phân bổ cho Thẩm phán Vernon Broderick. Đối với Perplexity, đây là một cơn ác mộng. Họ sẽ phải chiến đấu hai lần với cùng một vấn đề pháp lý tại hai tòa án khác nhau, trước hai vị thẩm phán khác nhau.
Vụ kiện của Chicago Tribune cũng tập trung xoáy sâu vào vấn đề ảo giác. Họ cho rằng những nội dung không do Tribune viết lại được hiển thị như thể là tin tức của chính tờ báo này. Họ thậm chí còn cáo buộc về việc làm loãng thương hiệu và bôi nhọ danh dự.
Vào tháng 10 năm 2025, Reddit đã bắt đầu một cuộc tấn công từ một góc độ hoàn toàn khác.
Đây không phải là vấn đề bản quyền, mà là Điều 1201 của DMCA, điều khoản về việc cấm vượt qua các biện pháp kiểm soát truy cập. Reddit không chỉ kiện Perplexity mà còn kiện cùng lúc ba đơn vị trung gian thu thập dữ liệu (SerpApi, Oxylabs, AWMProxy). Họ đã sử dụng cụm từ "rửa dữ liệu".
Vì Perplexity không thể trực tiếp cào dữ liệu từ Reddit nên nó đã đi đường vòng thông qua kết quả tìm kiếm của Google. Reddit đã giăng một cái bẫy. Họ đăng một bài viết thử nghiệm mà chỉ Google mới có thể nhìn thấy, và chỉ trong vòng vài giờ, nó đã xuất hiện trong câu trả lời của Perplexity.
Danh sách các bản thảo đang tiếp tục tăng lên. Từ Bách khoa toàn thư Britannica, US News & World Report, cho đến các cơ quan báo chí của Nhật Bản và Ý. Hiện tại, có ít nhất 6 vụ kiện đang được tiến hành chống lại Perplexity.
Lập luận của Perplexity rất nhất quán. Đó là lời của Jesse Dwyer, Giám đốc Truyền thông: "Các cơ quan báo chí đã kiện các công ty công nghệ mới trong suốt 100 năm qua. Từ radio, TV, internet, mạng xã hội, và giờ là AI. May mắn thay, họ chưa bao giờ thành công. Nếu thành công, có lẽ bây giờ chúng ta vẫn đang trò chuyện bằng điện tín."
Tuy nhiên, bên ngoài tòa án cũng đang có những chuyển động khác. Perplexity đã ký kết các hợp đồng chia sẻ doanh thu với Time, Fortune và Der Spiegel. Họ cũng đã thiết lập quan hệ đối tác với Getty Images.
Việc kiện tụng và thương lượng đang diễn ra đồng thời. Nếu thua tại tòa, bạn sẽ phải nhượng bộ nhiều hơn trên bàn thương lượng. Nếu đạt được thỏa thuận tại bàn thương lượng, cuộc chiến pháp lý sẽ kết thúc. Cả hai bên đều đang tính toán điều này.
Hạn chót cung cấp chứng cứ cho vụ kiện Dow Jones là vào tháng 6 năm 2026. Liệu mã nguồn của Perplexity sẽ được công khai vào thời điểm đó, hay một thỏa thuận sẽ được đạt được trước đó. Câu trả lời cho câu hỏi này sẽ quyết định tương lai của AI dạng tìm kiếm.
II. Định nghĩa về vụ kiện tập thể của các tác giả và sự sáng tạo
George R.R. Martin đã dành hàng thập kỷ để viết nên bộ tiểu thuyết nguyên tác 《Trò chơi vương quyền》. Văn phong của ông độc đáo, thế giới quan rộng lớn và các nhân vật thì đầy phức tạp. Một ngày nọ, người hâm mộ đã gửi đến ông một thông tin kỳ lạ. Họ nói rằng khi nhập câu lệnh "Hãy viết phần 6 của Trò chơi vương quyền theo phong cách George R.R. Martin" vào ChatGPT, nó đã tạo ra một cuốn tiểu thuyết khá là thuyết phục. Martin đã thực sự bị sốc.
(1) Vụ kiện của Authors Guild và Hiệp hội các tác giả: Sự mô phỏng phong cách và các điều kiện để hình thành tác phẩm phái sinh
Tháng 9 năm 2023, Hiệp hội các Tác giả Hoa Kỳ (Authors Guild) cùng các tác giả nổi tiếng như George R.R. Martin, John Grisham, Jodi Picoult đã khởi kiện OpenAI. Lập luận của họ rất rõ ràng.
"Không có sự đồng ý, không có sự công nhận, và không có sự đền bù (No Consent, No Credit, No Compensation)."
Có một khái niệm gọi là tác phẩm phái sinh (derivative work). Đó là việc tạo ra các bản remix, phim ảnh, v.v. dựa trên bản gốc mà không cần phải phát lại nguyên vẹn bản gốc đó.
Các tác giả lập luận rằng AI có thể học toàn bộ sách của họ để tạo ra các văn bản mô phỏng phong cách và văn phong của họ, và điều này cấu thành nên một tác phẩm phái sinh từ nguyên tác.
Tuy nhiên, tòa án đã rất thận trọng. Luật bản quyền bảo hộ "biểu hiện" cụ thể, chứ không bảo hộ chính "phong cách vẽ" hay "lối vẽ" của tác giả. Văn phong cũng tương tự như nét chữ. Nét chữ có thể gợi nhắc đến một người, nhưng bản thân nó không phải là đối tượng của bản quyền.
Vào ngày 3 tháng 4 năm 2025, nhiều vụ kiện tập thể của các tác giả chống lại OpenAI đã được hợp nhất thành một vụ kiện đa quận (MDL). Vào ngày 27 tháng 10 cùng năm, Thẩm phán Stein đã bác bỏ yêu cầu bác bỏ đơn kiện của OpenAI. Tòa án phán quyết rằng các nguyên đơn đã đưa ra đầy đủ các cáo buộc sơ bộ (prima facie claim) về việc vi phạm bản quyền. Theo đó, các cáo buộc về việc sao chép thực tế và sự tương đồng đáng kể giữa kết quả đầu ra của ChatGPT và các tác phẩm của các tác giả đã được đưa ra một cách đầy đủ.
Các vấn đề tranh luận có thể được tóm gọn thành hai nhánh.
Một là sao chép trái phép trong giai đoạn học tập.
Một yếu tố khác là sự tương đồng về mặt thực tế trong kết quả đầu ra.
Phía tác giả lập luận rằng lời giải thích "mô hình tạo ra các câu văn dựa trên xác suất" có thể là một màn sương mù nhằm che đậy cấu trúc lợi ích kinh tế dựa trên việc sao chép quy mô lớn. Phía bị cáo nhấn mạnh gánh nặng chứng minh mối quan hệ nhân quả và sự tương đồng thực tế, với lập luận rằng "mỗi kết quả đầu ra là kết quả của quá trình xác suất và dữ liệu đầu vào của người dùng".
Vào ngày 3 tháng 4 năm 2025, Ủy ban Phân phối Đa khu vực (JPML) đã hợp nhất các vụ kiện tập thể của nhiều tác giả chống lại OpenAI thành MDL số 3143. Vụ việc đã được phân bổ cho Thẩm phán Sidney Stein tại Tòa án Quận phía Nam New York. 12 vụ kiện đã được gộp lại làm một, bao gồm: vụ kiện của Authors Guild, vụ kiện của New York Times, vụ kiện của Sarah Silverman và vụ kiện của Michael Chabon.
Vào cùng ngày 27 tháng 10 cùng năm đó, Thẩm phán Stein đã bác bỏ yêu cầu bác bỏ đơn kiện của OpenAI. Ông nhận định rằng các nguyên đơn đã đưa ra đầy đủ các bằng chứng sơ bộ (prima facie claim) về việc vi phạm bản quyền. Lập luận cho rằng "các bản tóm tắt của ChatGPT đã bắt chước (parroting) cốt truyện, nhân vật và chủ đề của tác phẩm gốc như một con vẹt" đã được chấp thuận.
Cuộc tranh luận về pháp lý đã kết thúc. Giờ là cuộc chiến của những bằng chứng.
Tính đến tháng 1 năm 2026, hai bên đã bước vào một cuộc chiến toàn diện về việc cung cấp chứng cứ (Discovery).
Tòa án đã triệu tập các phiên họp về tình trạng tiết lộ chứng cứ liên tiếp vào ngày 15 tháng 1 và ngày 11 tháng 2. Vấn đề mấu chốt là danh tính của các tập dữ liệu mà OpenAI đã sử dụng để huấn luyện: 'Books1' và 'Books2'. Hai tập dữ liệu này chính là chìa khóa của mọi chuyện. Câu chuyện bắt đầu quay ngược về năm 2018.
Một nhân viên của OpenAI đã tải xuống hàng triệu cuốn sách từ một trang web vi phạm bản quyền có tên là Library Genesis (LibGen). Dựa trên dữ liệu này, Books1 và Books2 đã được tạo ra. Vào tháng 5 năm 2020, OpenAI đã công khai tuyên bố trong một bài báo nghiên cứu rằng họ đã sử dụng bộ dữ liệu này để huấn luyện GPT-3. Và vào năm 2022, ngay trước khi ra mắt ChatGPT, họ đã xóa bỏ chúng.
Tại sao lại xóa nó? Câu hỏi này sẽ quyết định khoản bồi thường thiệt hại lên đến hàng tỷ đô la.
Vào tháng 3 năm 2024, Joseph Gratz, luật sư bên ngoài của OpenAI, đã gửi một bức thư cho luật sư của phía tác giả. "Books1 và Books2 đã bị loại khỏi quá trình huấn luyện vào cuối năm 2021, và đã bị xóa vào giữa năm 2022 với lý do 'không sử dụng (non-use)'."
Tuy nhiên, khi phía tác giả đào sâu vào ý nghĩa của cụm từ 'không sử dụng' này, OpenAI đã thay đổi lời nói. Vào ngày 13 tháng 6 năm 2025, OpenAI đã cố gắng rút lại phần tương ứng trong thư gửi Graz. Họ lập luận rằng lý do xóa bỏ được đưa ra trong cuộc hội thoại với luật sư, nên được bảo vệ bởi đặc quyền luật sư-thân chủ (attorney-client privilege).
Thẩm phán Ona Wang đã không chấp nhận điều này. Vào ngày 24 tháng 11 năm 2025, bà đã ra lệnh: "OpenAI không thể đưa ra 'lý do' (ngụ ý rằng đó không phải là đặc quyền), rồi sau đó lại tuyên bố rằng 'lý do' đó là đặc quyền. OpenAI đã thay đổi các tuyên bố về đặc quyền giống như một 'mục tiêu di động'."
Tòa án đã ra lệnh công khai các tin nhắn trong các kênh Slack nội bộ của OpenAI, cụ thể là các kênh có tên "project-clear" và "excise-libgen" – nơi các nhân viên đã thảo luận về việc xóa bỏ các tập dữ liệu. Tất cả các trao đổi bằng văn bản với các luật sư nội bộ của công ty trong năm 2022 cũng thuộc diện phải công khai, cùng với mọi đề cập nội bộ liên quan đến LibGen. Thời hạn chót là ngày 8 tháng 12 năm 2025. Việc hoàn tất bản ghi lời khai của các luật sư nội bộ OpenAI được yêu cầu phải thực hiện trước ngày 19 tháng 12.
OpenAI đã tuyên bố sẽ kháng cáo. Tuy nhiên, vào ngày 3 tháng 12 năm 2025, Thẩm phán Wang cũng đã bác bỏ đơn yêu cầu xem xét lại. Vào ngày 5 tháng 12, Thẩm phán Stein đã ra lệnh cho OpenAI phải nộp thêm các văn bản ý kiến bổ sung. Tại sao những bằng chứng này lại quan trọng? Nếu việc "vi phạm cố ý (willful infringement)" được chứng minh, cục diện sẽ thay đổi. Theo luật bản quyền, vi phạm cố ý có thể dẫn đến mức bồi thường thiệt hại định mức lên tới 150.000 đô la cho mỗi tác phẩm. Có hàng triệu cuốn sách liên quan đến vụ việc này.
Trách nhiệm pháp lý về mặt lý thuyết có thể lên tới hàng chục tỷ đô la. Nếu OpenAI biết rõ đó là bản sao lậu mà vẫn sử dụng, và sau đó xóa bỏ để che giấu sự thật, thì mức bồi thường thiệt hại sẽ tăng lên con số thiên văn.
Luật sư Justin Nelson, đại diện cho phía tác giả, đã từng có kinh nghiệm giành chiến thắng trên các mặt trận khác. Ông cũng đang theo dõi liệu các mô hình mà OpenAI đang phát triển có đang sử dụng dữ liệu vi phạm bản quyền hay không, và liệu các tập dữ liệu đã bị xóa có đang tiếp tục được sử dụng dưới một cái tên khác hay không.
Tình hình của tháng 1 năm 2026 có thể được tóm tắt như sau. Việc OpenAI công khai dữ liệu huấn luyện minh bạch đến mức nào, và các tác giả tìm ra được bao nhiêu dấu vết của các bản sao lậu trong dữ liệu đó, sẽ là yếu tố quyết định thắng bại.
Áp lực đối với OpenAI đang ngày càng gia tăng ngay cả bên ngoài các vụ kiện tụng. Đó là do tiền lệ từ đối thủ cạnh tranh Anthropic. Vào tháng 9 năm 2025, Anthropic đã đồng ý chi trả 1,5 tỷ USD. Đây là khoản tiền dàn xếp bản quyền lớn nhất trong lịch sử Hoa Kỳ. Thỏa thuận 1,5 tỷ USD của Anthropic giờ đây đã trở thành một cột mốc chuẩn mực.
Nếu OpenAI thua tại tòa, họ sẽ phải trả giá nhiều hơn thế rất nhiều. Ngay cả khi thắng, họ cũng đã phải chịu đựng chi phí pháp lý và tổn hại danh tiếng trong suốt nhiều năm qua. Và mặt trận tiếp theo đã mở ra. Các tài liệu nội bộ cho thấy Meta cũng đã sử dụng cùng một tập dữ liệu LibGen. Đây là bằng chứng cho thấy Mark Zuckerberg đã phê duyệt dù biết rõ về "mức độ rủi ro pháp lý từ trung bình đến cao".
Cuộc chiến pháp lý của các tác giả chỉ vừa mới bắt đầu.
(2) Xu hướng kiện tập thể và hòa giải đối với Anthropic
Ngày 5 tháng 9 năm 2025, tại một tòa án ở San Francisco, một con số đã được xướng lên. 1,5 tỷ đô la. Cả khán phòng trở nên im lặng. Anthropic đã đạt được một thỏa thuận hòa giải lớn nhất trong lịch sử luật bản quyền Hoa Kỳ trong vụ kiện với các tác giả.
Sự việc này bắt đầu vào năm 2024. Các tác giả Andrea Bartz, Charles Graeber và Kirk Wallace Johnson đã khởi kiện Anthropic.
Anthropic đang đối mặt với cáo buộc đã sử dụng dữ liệu từ các trang web sách lậu như 'LibGen' (Library Genesis) và 'PiLiMi' (Pirate Library Mirror) trong quá trình huấn luyện mô hình AI 'Claude' của mình.
Vào tháng 6 năm 2025, Thẩm phán William Alsup của Tòa án Liên bang miền Bắc California đã đưa ra một phán quyết mang tính quyết định. Việc sử dụng các cuốn sách được mua một cách hợp pháp để huấn luyện là "một trong những điều mang tính biến đổi nhất trong đời chúng ta" và thuộc phạm vi sử dụng hợp lý. Tuy nhiên, việc sử dụng các tác phẩm vi phạm bản quyền là "về bản chất, mang tính xâm phạm không thể đảo ngược" và không thể được coi là sử dụng hợp lý.
Thẩm phán Alsub đã từ chối phán quyết rút gọn đối với các bản sao lậu và ra lệnh xét xử. Theo luật bản quyền của Hoa Kỳ, hành vi vi phạm cố ý có thể dẫn đến mức bồi thường thiệt hại định mức lên tới 150.000 đô la cho mỗi tác phẩm. Số lượng sách được tải xuống trái phép bởi Anthropic là khoảng 500.000 cuốn. Nếu tính toán, trách nhiệm pháp lý tiềm tàng có thể vượt quá 70 tỷ đô la. Đó là một con số có thể khiến cả công ty phá sản.
Anthropic đã ngồi vào bàn đàm phán. Các điều khoản thỏa thuận như sau: Thanh toán tối thiểu 1,5 tỷ USD. Khoảng 3.000 USD sẽ được phân bổ cho mỗi cuốn sách. Tiêu hủy các bản sao tác phẩm thu được từ các trang web lậu. Tuy nhiên, thỏa thuận này chỉ cấp quyền miễn trừ đối với các hành vi trong quá khứ. Các khiếu nại về vi phạm đối với việc huấn luyện hoặc đầu ra của AI trong tương lai sẽ không bao gồm trong thỏa thuận này.
Vào ngày 25 tháng 9 năm 2025, Thẩm phán Alsub đã phê duyệt sơ bộ thỏa thuận này. Phiên điều trần phê duyệt cuối cùng dự kiến diễn ra vào tháng 4 năm 2026. Mary Rasenberger, CEO của Hiệp hội Tác giả, đã phát biểu: "Thỏa thuận mang tính lịch sử này là một bước tiến quan trọng nhằm công nhận rằng các công ty AI không thể chiếm đoạt các tác phẩm sáng tạo của tác giả chỉ với lý do họ cần sách để phát triển các mô hình ngôn ngữ lớn chất lượng cao."
Có ba bài học rút ra từ thỏa thuận này. Thứ nhất, con đường thu thập dữ liệu đã trở thành trọng tâm của các rủi ro kiện tụng. Thứ hai, "xóa bỏ và dọn dẹp" không còn đơn thuần là vấn đề đạo đức, mà đã trở thành biến số then chốt trong việc cứu trợ và tính toán mức độ thiệt hại. Thứ ba, thị trường cấp phép (license) đã bắt đầu đóng vai trò không phải là một 'lựa chọn', mà là một 'tuyến phòng thủ'.
(3) Vụ kiện hợp nhất Silverman, Kadrey, Chabon kiện Meta MDL
Vào ngày 7 tháng 7 năm 2023, diễn viên hài Sarah Silverman đã phát hiện ra rằng cuốn hồi ký của mình, 『The Bedwetter』, đã bị AI của Meta nuốt chửng. Cô cùng với các tác giả Richard Kadrey và Christopher Golden đã khởi kiện Meta.
Vụ kiện đã nhanh chóng mở rộng lên tới 13 tác giả, bao gồm cả Michael Shea von, Juno Diaz, Andrew Sean Greer, và hai tác phẩm từng đoạt giải Pulitzer.
Thứ mà họ chỉ ra chính là bộ dữ liệu có tên 'Books3'. Khoảng 190.000 cuốn sách. Hầu hết đều là bản sao lậu từ một thư viện bóng tối có tên là Bibliotik. Meta đã sử dụng bộ dữ liệu này để huấn luyện LLaMA.
Các tài liệu nội bộ của Meta được công bố vào đầu năm 2025 còn gây sốc hơn nữa. Nội dung cho thấy Mark Zuckerberg đã trực tiếp phê duyệt việc sử dụng bộ dữ liệu LibGen và hoàn toàn nhận thức được rằng đó là bản lậu.
Vào ngày 25 tháng 6 năm 2025, Thẩm phán Vince Chabria của Tòa án Liên bang miền Bắc California đã tuyên thắng kiện cho Meta. Phán quyết cho rằng hành vi sao chép trái phép các cuốn sách có bản quyền để huấn luyện AI thuộc phạm vi sử dụng hợp lý (fair use). Ông đã sử dụng cụm từ "có tính biến đổi cao (highly transformative)".
Hai ngày trước, tại một phiên tòa khác, một phán quyết hoàn toàn trái ngược đã được đưa ra. Đó là phán quyết của Thẩm phán William Alsup trong vụ việc Anthropic. Thẩm phán Alsup đã công nhận rằng việc quét các cuốn sách được mua một cách hợp pháp để huấn luyện AI là sử dụng hợp lý (fair use). Ông thậm chí còn gọi đó là "một trong những mục đích mang tính biến đổi nhất trong đời chúng ta". Tuy nhiên, ông đã vạch rõ ranh giới rằng việc sử dụng các cuốn sách được tải xuống từ các trang web lậu không phải là sử dụng hợp lý. Anthropic đã phải chi trả 1,5 tỷ đô la để đạt được thỏa thuận.
Hai phán quyết được đưa ra trong cùng một tuần. Dù có vẻ cùng một vấn đề tranh chấp, nhưng kết quả lại khác nhau. Tại sao lại như vậy?
Hai thẩm phán đã có những góc nhìn khác nhau về vấn đề tranh chấp. Thẩm phán Al-seop đã đặt câu hỏi về việc "dữ liệu đã được thu thập như thế nào". Ông phán quyết rằng bản thân hành vi tải xuống từ các trang web sao chép bất hợp pháp không thể được bảo hộ dưới hình thức sử dụng hợp lý.
Thẩm phán Chabria đã hỏi "dữ liệu đã được sử dụng như thế nào". Vì mục đích đào tạo AI là một mục đích biến đổi hoàn toàn khác so với tác phẩm gốc, nên điều này được xem là sử dụng hợp lý.
Còn có một sự khác biệt mang tính quyết định khác.
Đó là sự thất bại trong việc đưa ra bằng chứng của phía nguyên đơn. Thẩm phán Chavria đã viết như vậy trong bản án.
"Meta đã đưa ra bằng chứng cho thấy việc sao chép không gây ra thiệt hại cho thị trường. Các nguyên đơn đã không thể đưa ra bất kỳ bằng chứng thực nghiệm nào ngược lại." Không có bằng chứng nào cho thấy LLaMA tạo ra văn bản tương tự về mặt bản chất với tác phẩm gốc. Nếu không có thiệt hại, sẽ không có thắng kiện.
Tuy nhiên, Thẩm phán Chabria đã đưa ra một lưu ý quan trọng. "Phán quyết này chỉ áp dụng cho các tình tiết cụ thể của vụ án này." Và ông nói thêm: "Nếu các nguyên đơn đưa ra được bằng chứng cho thấy LLaMA cho phép tạo ra các tác phẩm cạnh tranh trực tiếp với tác phẩm của họ, thì kết quả có thể đã khác."
Câu nói này đã mở ra một con đường mới cho các bản thảo.
Ngày 27 tháng 10 năm 2025, Meta đã gửi thông báo cho phía nguyên đơn. Nội dung thông báo cho biết họ đã tìm thấy "bằng chứng mới" liên quan đến việc tải xuống các tệp thông qua giao thức torrent từ Shadow Library trong quá khứ. Vào ngày 5 tháng 11, cả hai bên đã yêu cầu gia hạn thời hạn. Phiên điều trần xét xử rút gọn đã được hoãn từ ngày 2 tháng 4 năm 2026 sang ngày 30 tháng 4 năm 2026.
Một chiến lược mới đã được tiết lộ.
Thay vì tranh luận về việc sử dụng hợp lý (fair use) trong giai đoạn học máy, mục tiêu là tấn công vào chính hành vi torrent. Đây là một nỗ lực nhằm áp dụng các nguyên tắc pháp lý mà Thẩm phán Alsup đã thiết lập trong vụ Anthropic cho cả Thẩm phán Chabria. Việc Meta tải xuống hàng triệu cuốn sách từ LibGen thông qua giao thức BitTorrent về bản chất cũng giống như việc Anthropic thu thập dữ liệu từ cùng một trang web. Tính bất hợp pháp của hành vi thu thập không được hóa giải bởi việc sử dụng mang tính biến đổi (transformative use) sau đó.
Tính đến tháng 1 năm 2026, vụ kiện vẫn đang tiếp diễn. Mặc dù phán quyết về việc sử dụng hợp lý (fair use) của Thẩm phán Chavria đã được xác lập, nhưng đó mới chỉ là một nửa câu chuyện. Nửa còn lại, vấn đề về torrenting, đang chờ đợi phiên điều trần vào ngày 30 tháng 4. Nếu các nguyên đơn giành chiến thắng trong vấn đề này, phán quyết về việc sử dụng hợp lý trong giai đoạn đào tạo sẽ trên thực tế bị vô hiệu hóa. Bởi lẽ, dù quá trình đào tạo có mang tính biến đổi đến đâu đi chăng nữa, nếu dữ liệu được thu thập bất hợp pháp thì sẽ không thể được bảo vệ.
Anthropic đã giải quyết vấn đề với 1,5 tỷ đô la. Meta đã quyết định sẽ chiến đấu đến cùng tại tòa án. Liệu lựa chọn đó có khôn ngoan hay không, chúng ta sẽ biết sau ngày 30 tháng 4.
c. AI tạo mã và giấy phép nguồn mở
Matthew Butterick là một luật sư kiêm lập trình viên. Với một lý lịch hiếm thấy, vào năm 2022, khi đang sử dụng 'Copilot' - một công cụ AI của GitHub, ông đã cảm thấy một sự quen thuộc kỳ lạ. Những đoạn mã mà Copilot đề xuất quá giống với những đoạn mã mà ông đã từng viết trong quá khứ, hoặc những đoạn mã mà ông đã từng thấy trong cộng đồng mã nguồn mở.
(1) Vụ kiện GitHub Copilot: Tranh cãi về vi phạm giấy phép nguồn mở
Phần mềm nguồn mở là một tòa tháp khổng lồ được xây dựng trên tinh thần 'chia sẻ'. Các nhà phát triển công khai mã nguồn của mình để bất kỳ ai cũng có thể xem được. Những người khác sẽ lấy mã nguồn đó để sử dụng. Có một quy tắc quan trọng ở đây.
Đó chính là 'license' (giấy phép). Nó tương tự như những công thức nấu ăn miễn phí được phát trên đường phố, nhưng là một tờ giấy có ghi kèm các điều kiện. Những câu như "Bạn có thể lấy nhưng phải ghi rõ nguồn", hay "Phải công khai lại với cùng một điều kiện" chính là các điều kiện đó. Đây là một lời hứa thiêng liêng giữa các nhà phát triển.
Vào ngày 3 tháng 11 năm 2022, Butterick cùng các nhà phát triển ẩn danh đã đệ đơn kiện tập thể chống lại Microsoft, GitHub và OpenAI lên Tòa án Liên bang khu vực phía Bắc California.
Copilot đã học hàng tỷ dòng mã nguồn mở. Và khi người dùng viết mã, nó sẽ thực hiện tính năng tự động hoàn thành dựa trên những gì đã học được. Vấn đề là khi Copilot đưa ra mã, nó lại xóa sạch tên của tác giả gốc cũng như các thông báo về bản quyền.
Butterick đã gọi đây là "vụ rửa bản quyền lớn nhất trong lịch sử phần mềm". Lập luận cốt lõi của phía nguyên đơn là vi phạm Điều 1202 của Đạo luật Bản quyền Thiên niên kỷ Kỹ thuật số (DMCA). Điều khoản này là một cơ chế nhằm ngăn chặn hành vi xóa hoặc thay đổi trái phép "Thông tin quản lý bản quyền (CMI)". Nói một cách dễ hiểu, nó cấm "hành vi xé bỏ tên tác giả trên bìa sách rồi phát tán các bản sao". Vào tháng 7 năm 2024, Thẩm phán Jon S. Tigar đã giáng một đòn mạnh vào phía nguyên đơn.
Yêu cầu theo Điều 1202(b) của DMCA đã bị bác bỏ. Lập luận của thẩm phán là: Mã nguồn do Copilot tạo ra không "giống hệt" với bản gốc. Do đó, DMCA không được áp dụng. Đây chính là 'yêu cầu về tính đồng nhất (identicality requirement)'.
Các nguyên đơn đã không bỏ cuộc. Vào ngày 27 tháng 9 năm 2024, Thẩm phán Tiger đã chấp thuận yêu cầu của các nguyên đơn và chứng thực việc chuyển vấn đề tranh chấp này lên Tòa phúc thẩm khu vực 9 dưới hình thức kháng cáo trung gian (interlocutory appeal).
Câu hỏi then chốt là thế này. Điều 1202(b) của DMCA chỉ áp dụng khi đầu ra của AI phải "giống hệt" với bản gốc, hay chỉ cần "tương tự" là đã có thể áp dụng? 17 U.S.C. § 1202(b)
(b) REMOVAL OR ALTERATION OF COPYRIGHT MANAGEMENT INFORMATION.—No person shall, without the authority of the copyright owner or the law—
(1) intentionally remove or alter any copyright management information,
(2) distribute or import for distribution copyright management information knowing that the copyright management information has been removed or altered without authority of the copyright owner or the law, or(3) distribute, import for distribution, or publicly perform works, copies of works, or phonorecords, knowing that copyright management information has been removed or altered without authority of the copyright owner or the law, knowing, or, with respect to civil remedies under section 1203, having reasonable grounds to know, that it will induce, enable, facilitate, or conceal an infringement of any right under this title.
Và tại Điều 1202(c), định nghĩa về "thông tin quản lý bản quyền (copyright management information)" đã được quy định.
(c) DEFINITION.—As used in this section, the term "copyright management information" means any of the following information conveyed in connection with copies or phonorecords of a work or performances or displays of a work, including in digital form:
(1) The title and other information identifying the work, including the information set forth on a notice of copyright.
(2) The name of, and other identifying information about, the author of a work.
(3) Tên và các thông tin nhận dạng khác về chủ sở hữu bản quyền của tác phẩm, bao gồm cả thông tin được nêu trong thông báo bản quyền. Câu trả lời cho câu hỏi này có thể thay đổi toàn bộ quy tắc của ngành công nghiệp AI.
Nếu tòa phúc thẩm xác nhận "yêu cầu về tính đồng nhất", các công ty AI có thể tránh được trách nhiệm pháp lý theo DMCA chỉ bằng cách thay đổi nhẹ mã nguồn. Ngược lại, nếu phán quyết cho rằng chỉ cần "tính tương đồng" là đủ, các công cụ AI lập trình sẽ phải gánh chịu gánh nặng khổng lồ trong việc truy vết và tuân thủ giấy phép của tất cả các mã nguồn mở có trong dữ liệu đào tạo.
Mặt khác, Thẩm phán Tiger đã không bác bỏ các cáo buộc về vi phạm giấy phép nguồn mở và vi phạm hợp đồng. Ông đã xem xét các giấy phép nguồn mở như những hợp đồng có tính ràng buộc pháp lý thực tế. Các cáo buộc này hiện vẫn đang trong quá trình tố tụng, và các nguyên đơn đang củng cố thêm bằng chứng cho thấy Copilot đã "ghi nhớ (memorization)" mã nguồn của họ để đưa vào kết quả đầu ra.
Trạng thái hiện tại: Đang chờ lịch tranh tụng trực tiếp hoặc phán quyết tại Tòa phúc thẩm khu vực 9. Vụ kiện sơ thẩm đang trong trạng thái tạm đình chỉ (stayed) cho đến khi có phán quyết của phiên phúc thẩm. Phán quyết này dự kiến sẽ tạo ra tiền lệ cho toàn bộ các tranh chấp về bản quyền AI.
(2) Vấn đề về tính hợp pháp của dữ liệu đào tạo của AI lập trình
Các tranh chấp liên quan đến AI lập trình là điểm xung đột trực diện giữa logic về "sử dụng hợp lý" và logic về "vi phạm hợp đồng". Tính hợp pháp của dữ liệu đào tạo là vấn đề về việc "nguồn nguyên liệu được mua từ đâu".
Lập luận của Microsoft và OpenAI rất quyết đoán. Việc học từ mã nguồn công khai của GitHub thuộc về phạm vi sử dụng hợp lý (fair use). Mã do AI tạo ra chỉ là một biến thể của mã gốc chứ không phải là bản sao. Những đoạn mã cực ngắn (Snippet) không thể được bảo hộ bản quyền. "for (int i=0; i"<10; i++)" như một vòng lặp đơn giản không thể thuộc sở hữu của riêng ai.
Ngược lại, phía các nhà phát triển lập luận rằng: Mã nguồn mở có nghĩa là 'bất kỳ ai cũng có thể xem', chứ không có nghĩa là 'bất kỳ ai cũng có thể sử dụng cho mục đích thương mại một cách tùy ý'. Giấy phép GPL đi kèm với nghĩa vụ công khai các sản phẩm phái sinh (copyleft). Giấy phép MIT cũng yêu cầu phải ghi danh tác giả. Khi Copilot được cung cấp dưới mô hình đăng ký trả phí, các tập đoàn nền tảng đang độc chiếm lợi nhuận bằng cách sử dụng mã nguồn được tạo ra từ nỗ lực của người khác.
Về mặt kỹ thuật, có ba vấn đề tranh chấp đang lặp lại.
Thứ nhất, việc sao chép giai đoạn học tập là sao chép tạm thời hay sao chép vĩnh viễn.
Thứ hai, liệu kết quả đầu ra có tái hiện 'phần trọng yếu' của mã nguồn trong một kho lưu trữ cụ thể hay không.
Thứ ba, là việc tại sao hệ thống đã loại bỏ khả năng truy xuất nguồn gốc và bản quyền dù về mặt thiết kế có thể thực hiện được.
Trong cuộc chiến này, tấm khiên mà các doanh nghiệp đưa ra là "tạo ra theo xác suất". Còn thanh kiếm mà các bản thảo đưa ra là "thống kê về việc xuất hiện trùng lặp và tái hiện khuôn mẫu". Ngay cả phần FAQ tự thân của GitHub cũng thừa nhận rằng "Trong khoảng 1% trường hợp, các đề xuất có thể bao gồm các đoạn mã dài hơn 150 ký tự trùng khớp với tập dữ liệu huấn luyện". Theo các phân tích độc lập, "trong các tệp đang hoạt động của Copilot, Copilot chiếm gần 40% mã nguồn của các ngôn ngữ lập trình phổ biến như Python".
Các nguyên đơn ước tính rằng chỉ riêng các khoản bồi thường thiệt hại theo luật định đối với vi phạm DMCA cũng có thể vượt quá 9 tỷ đô la. Vụ kiện này còn liên quan đến tương lai của nghề lập trình viên. Trớ trêu thay, bằng việc chia sẻ mã nguồn của mình, các lập trình viên đã vô tình huấn luyện nên chính trí tuệ nhân tạo (AI) sẽ thay thế họ.
Trong cộng đồng nguồn mở, các cuộc thảo luận về việc phát triển các giấy phép mới bao gồm các điều khoản rõ ràng về việc huấn luyện AI đang được tiến hành. Một số dự án đang thêm điều khoản "loại trừ huấn luyện AI" vào giấy phép của họ. Mã nguồn có cấu trúc rõ ràng hơn so với văn bản hay hình ảnh, và các quy tắc về giấy phép bản quyền cũng đã được thiết lập tương đối hoàn chỉnh. Do đó, kết quả của vụ kiện này có khả năng sẽ được đưa ra sớm hơn so với các phán quyết trong lĩnh vực văn bản hay hình ảnh, và sẽ trở thành một thước đo quan trọng cho các cuộc chiến bản quyền AI trong tương lai.
Giờ đây, tòa án phải đưa ra quyết định. Liệu có cho phép hệ sinh thái mã nguồn mở, vốn được tạo nên từ tinh thần chia sẻ, lại trở thành nguồn nhiên liệu cho AI – thứ đang nghịch lý thay đang gặm nhấm chính hệ sinh thái đó hay không. Và quyết định này sẽ tạo nên những nguyên tắc áp dụng cho tất cả các bài báo của các cơ quan truyền thông, sách của các tác giả, và cả mã nguồn của các nhà phát triển.
Luật sư Kim Kyung-jin
Luật sư · Cựu Nghị sĩ · Nhà nghiên cứu chính sách AI
© 2026 Kim Kyung-jin. Bảo lưu mọi quyền.